
須多先生
みなさん お疲れ様でした
アクティビティはいかがでしたか?
8. チャット学習② ( 8 / 13 )

須多先生
みなさん お疲れ様でした
アクティビティはいかがでしたか?
深田 あい
「入力層」のユニットの数は 入力する単語の数分必要だということがわかりました
徳井 天
「出力層」のユニットの数は 出力する結果の数分必要だったから 今回の場合は3つのユニットになるということもわかったよ
深田 あい
分からないところのサポートをしてもらえて (ユーザー名)さんのおかげで助かったよ ありがとう!
徳井 天
ディープラーニングの学習方法についてしっかり理解できたし じゃあ早速ディープラーニングでテキスト分類をしてみよう!
深田 あい
えっと 今回使うデータは…「ポジティブな意見」「ネガティブな意見」「質問や問い合わせ」で あらかじめアノテーションされてある200件のデータを使って学習させるんでしたよね 先生
須多先生
はい その通りです
ですが 実はディープラーニングで学習させるには 200件ではデータが少なすぎるんです
徳井 天
え!?200件って 相当多いと思ったんだけど…少ないのか?あとどれくらいのデータが必要なんだろう…?
須多先生
必要なデータ量を見極めるのは難しいですが テキスト分析は複雑なので かなり多くのデータが必要になることが多いです
高い精度を求めるのであれば 今の10倍以上は必要でしょう
深田 あい
10倍以上!?そんなに必要なんですか!?
徳井 天
200件のアノテーションデータを用意するのも大変だったのにショックだな…
須多先生
少ないデータでも学習自体を行うことはできますが その場合は「過学習」が起こる可能性が高くなります
「過学習」については こちらの動画で復習してくださいね
須多先生
これこそがディープラーニングの扱いの難しい点になります
そのため 少ないデータでもある程度の精度が出せる シンプルな手法との使い分けが重要になります
深田 あい
そういえば 認識編の犬種を認識するアクティビティで「学習済みのモデル」を使いましたよね
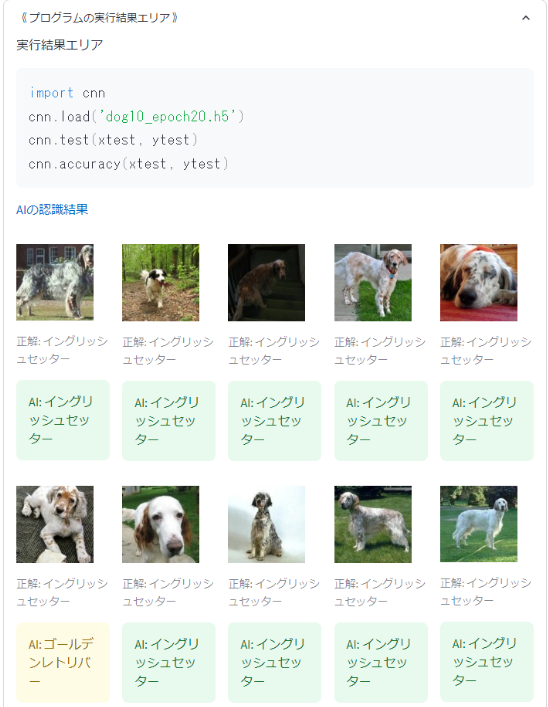
徳井 天
たしか学習済みのモデルを使ったら 一瞬で犬種を認識できたんだったよな
深田 あい
あの時は 犬種を認識するための「学習モデル」だったけど テキスト分類をするための「学習済みモデル」はないんですか?
須多先生
みなさん よく覚えていましたね
まさに今 その「学習済みモデル」を使用することを提案しようと思っていました
須多先生
テキストを「ポジティブな意見」「ネガティブな意見」に分類することができる「感情分析」の学習済みモデルは 様々な用途で利用されます
深田 あい
そのモデルを使って 分析してみたいです!
徳井 天
決定木よりも精度が上がればいいな
楽しみだな!
須多先生
それでは STAR Colabに 感情分析の「学習済みモデル」を用意しましたので 次のアクティビティの指示に従って進めてください

