
大規模言語モデル(LLM)が 人間の言葉に近い 自然な文章をどのように理解して生成しているのか その仕組みについて学びましょう
5. スライド学習① ( 5 / 14 )

LLMが文章を理解する仕組み
「言語モデル」とは?
「言語モデル」とは、文章の並び方を学習したAIのことで、大規模言語モデル(LLM)は、これをさらに発展させたものです。
この「言語モデル」により、LLMは、大量の文章データを使って「次に続く文章は何か」という予測を繰り返し学習することで、人間らしい文章を生成したり、複雑な質問に答えたりする能力を身に着けています。
LLMが文章を理解する仕組み
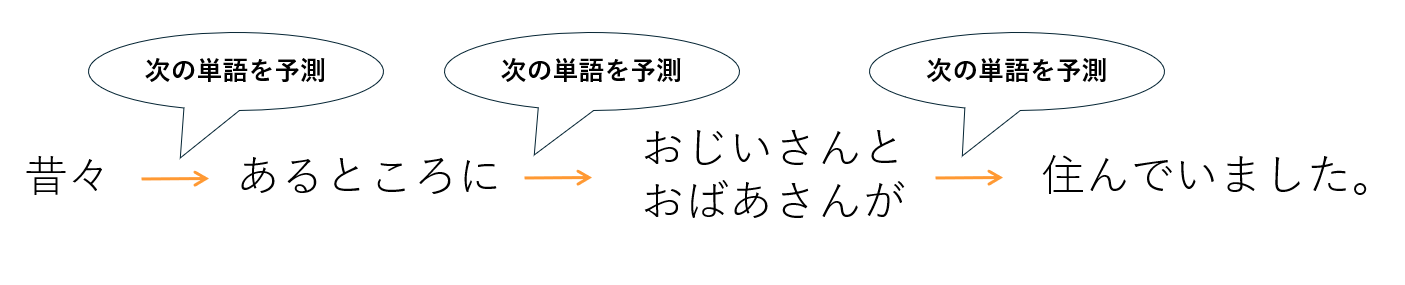
LLMは大量のテキストデータを使って、文章の並びが自然な文章には「次に続く文章となる確率」を「高く」割り当て、不自然な文章には「次に続く文章となる確率」を「低く」割り当てることで学習を進めます。
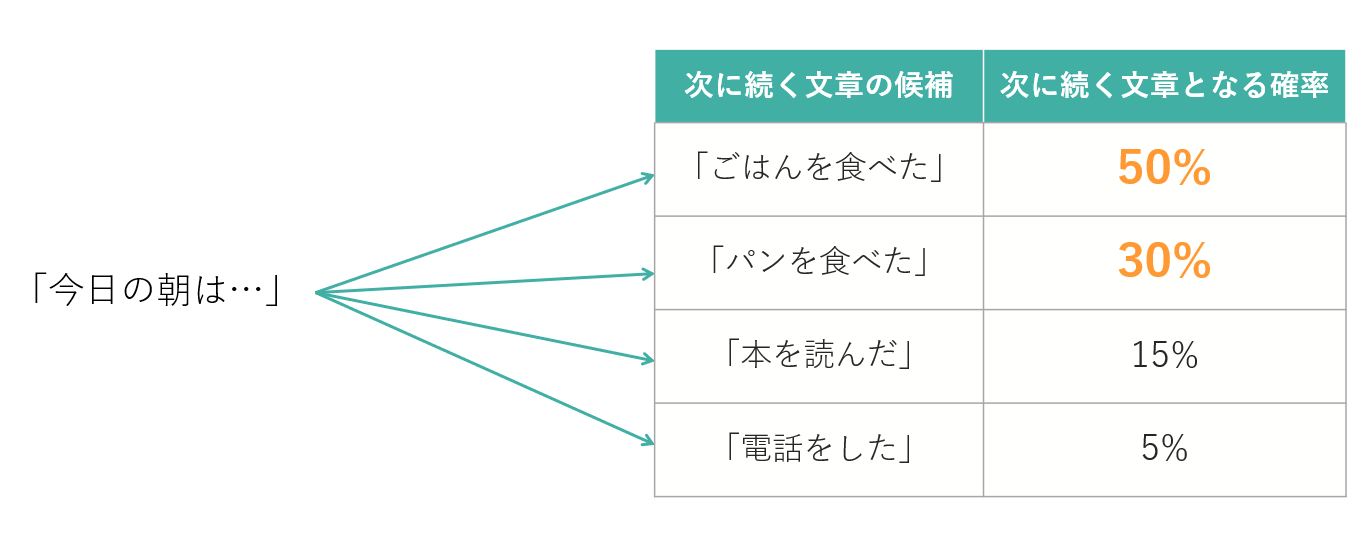
例えば、「今日の朝は」の後に続く文章として「ごはんを食べた」「パンを食べた」といった、一般的な朝の行動となる「文章の並びが自然な文章」には「次に続く文章となる確率」を「高く」割り当てます。
一方で「本を読んだ」「電話をした」は、一般的な朝の行動としては少し不自然なため「次に続く文章となる確率」が「低く」割り当てられます。
それでは、次の例はどうでしょうか?
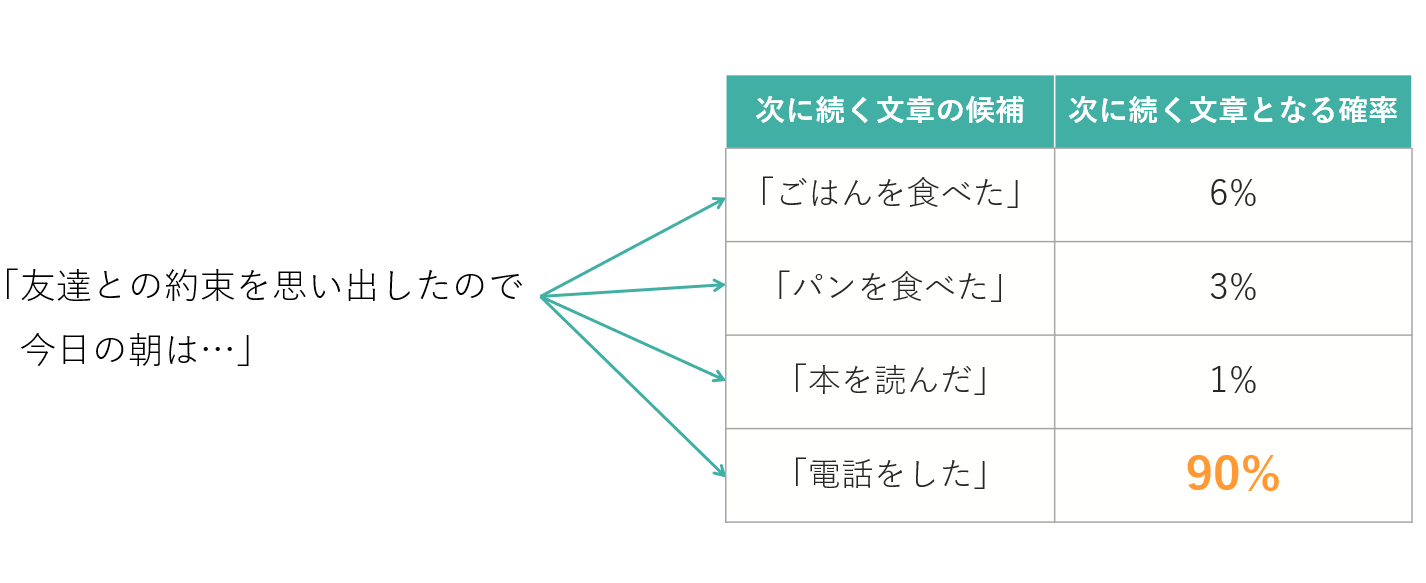
「友達との約束を思い出したので今日の朝は」の後に続く文章として、友達とのコミュニケーションが連想される「電話をした」という文章に、「次に続く文章となる確率」が「高く」割り当てられます。
このようにLLMは、日常会話などから学んだ文章のパターンから、「文章の穴埋め問題」を解くようなイメージで、適切な単語や文章のつながりを予測し、新しい文章を作り出します。
LLMは確率に基づいて動作しているため 間違った回答をしてしまうことがあります
また 間違った情報を学習してしまうと 生成される文章にもその誤りが含まれてしまうことがあります
生成AIの答えは完璧ではないということを 覚えておきましょう

