
このスライドでは 「共起ネットワーク」について学びます
共起ネットワークの見方と 単語間の関連性を算出する方法を このスライドで確認しましょう
3. スライド学習① ( 3 / 12 )

このスライドでは 「共起ネットワーク」について学びます
共起ネットワークの見方と 単語間の関連性を算出する方法を このスライドで確認しましょう
「共起ネットワーク」とは、文書の中に出現する単語同士の関連性を、視覚的に表現する技術です。
共起ネットワークは、円や線などで表現されていて、それぞれ意味があります。
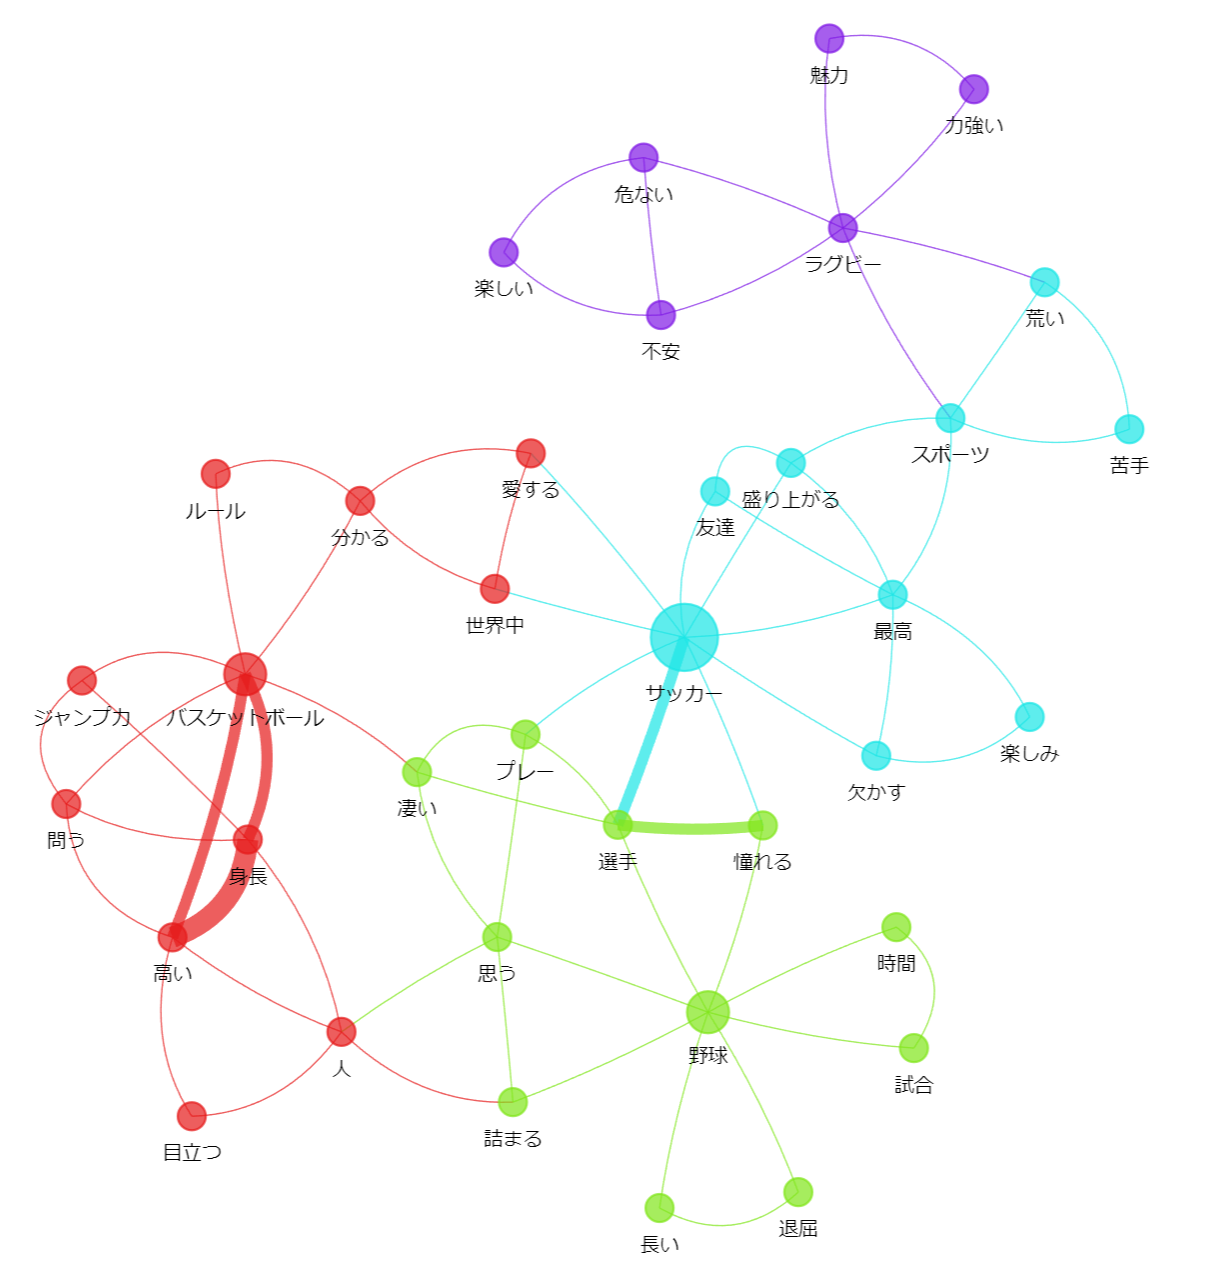
上の図は スポーツに関してのアンケートの回答を テキストデータの前処理であるクリーニングを行い 「名詞」「動詞」「形容詞」を抽出したテキストデータを元に作成した共起ネットワークです
この例を見ながら 共起ネットワークの見方を学び どのようなことを表しているのか一緒に考えてみましょう
ノードには、文章中に出現する単語が書かれてあります。ノードの大きさは、単語の出現頻度を表し、大きいほど単語の出現回数が高くなります。
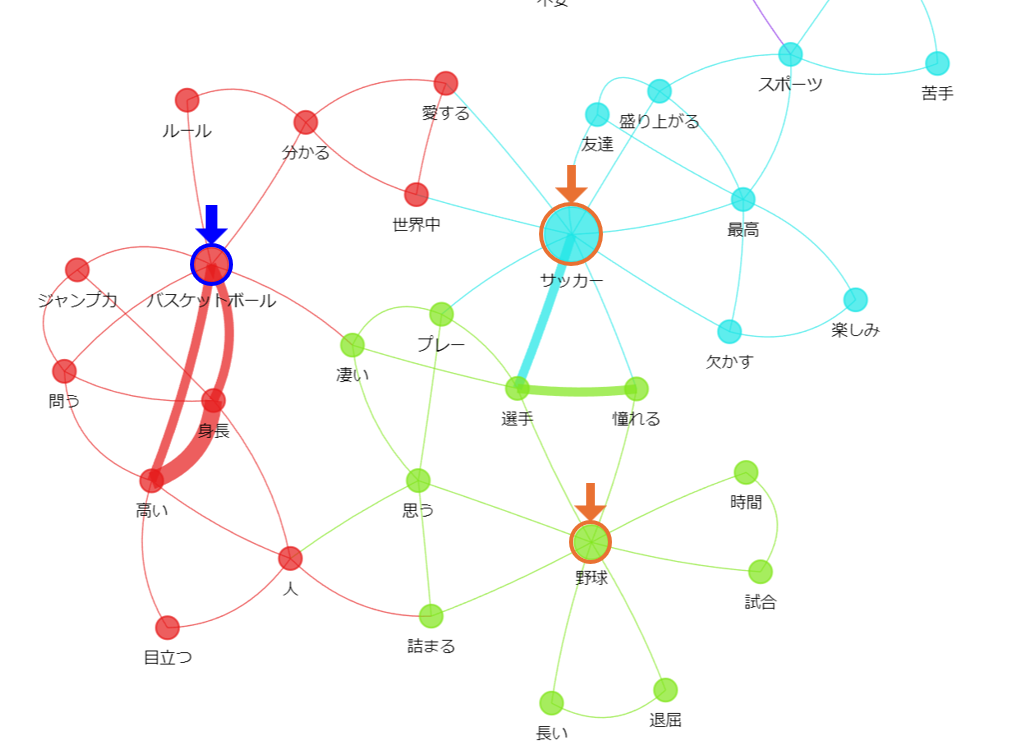
図を見ると「サッカー」「バスケットボール」「野球」などのノードが大きく表示されているので 出現頻度が高いことが分かりますね
同じ色のノードは、そのノードが属するグループを示し、似た性質を持つ単語同士でグループ分けされます。
グループ分けの方法は、分析を行う目的や、算出方法などにより異なります。
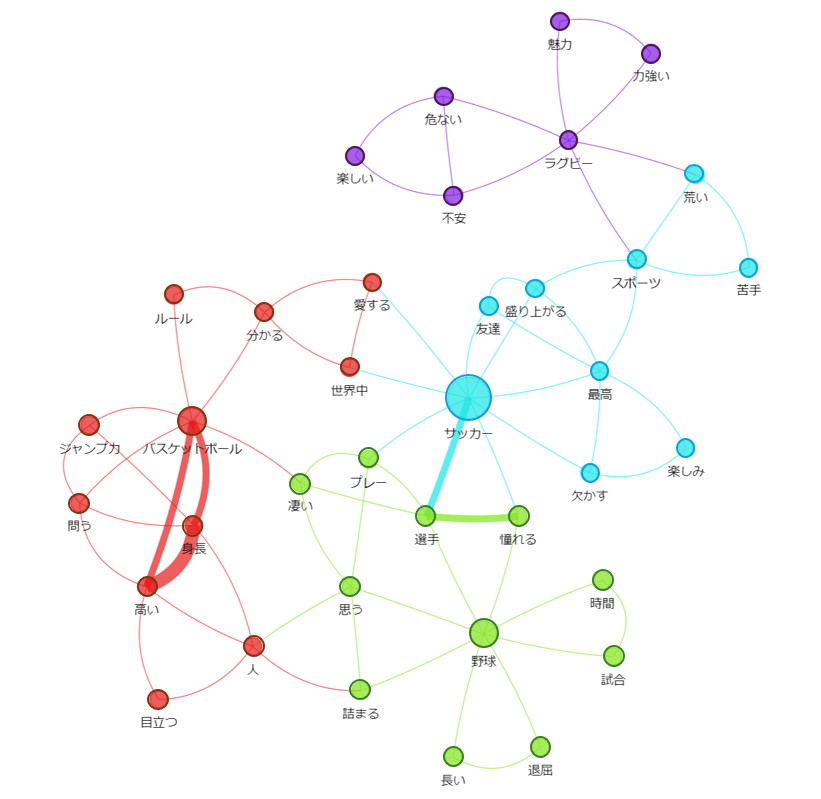
水色のグループは「サッカー」 赤のグループは「バスケットボール」 みたいに 似た性質を持つ単語同士でグループ分けされてるように見えるな
単語が書かれてあるノード同士をつなぐエッジは、つないだ単語同士が同時に出現する、関連性が高いことを表しています。
線が太くなっている場合、つないだ単語同士の関連性が、より高いことを表しています。
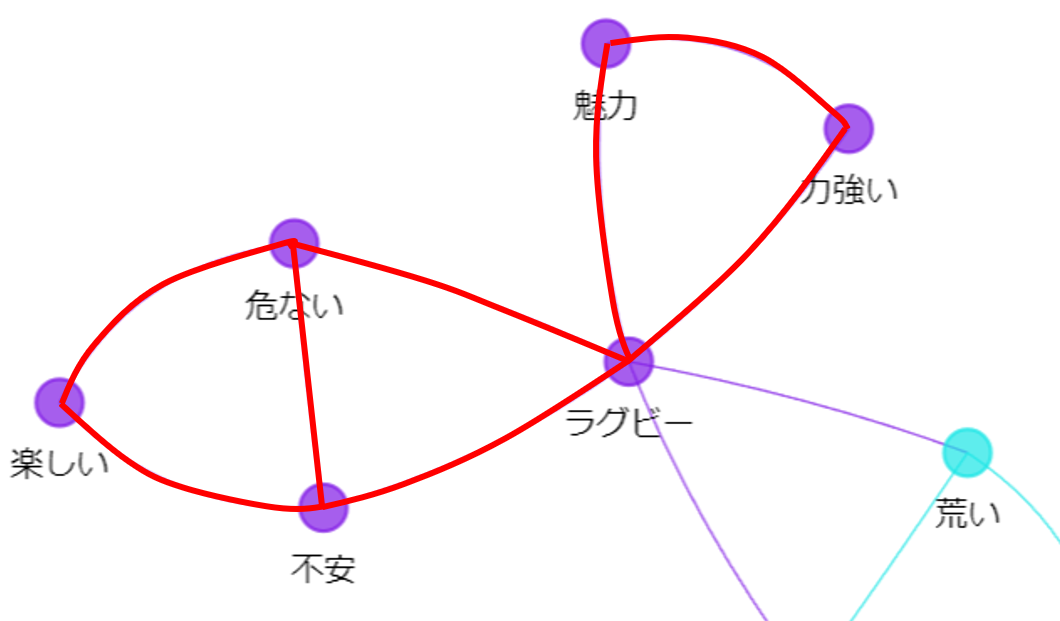
紫のグループを見ると 「ラグビー」「危ない」「不安」「力強い」「魅力」などがエッジでつながれていますね
ラグビーに対して 危ないや不安などの思いがある人もいれば 力強くて魅力という風に 様々な意見があることが分かります
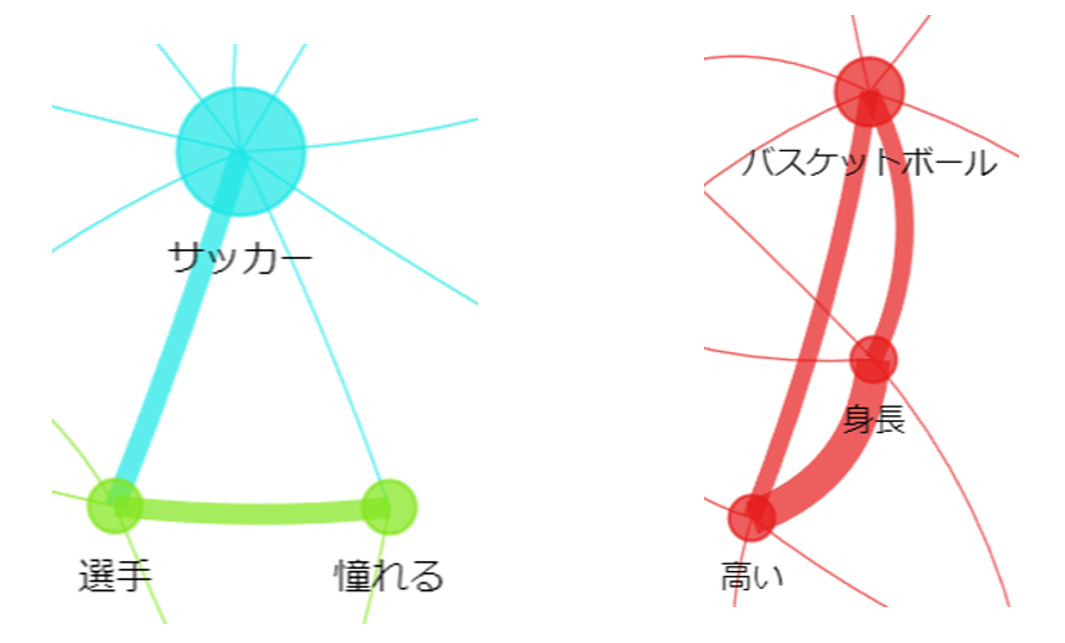
例えば 真ん中のノードとつながるエッジを見ると「サッカー」「選手」や「選手」「憧れる」
左の赤いグループは「バスケットボール」「身長」「高い」などが太いエッジでつながれていることが分かるな
共起ネットワークの見方について理解できましたか?
次のコラムでは共起ネットワークを作成する際の 単語同士の関連性の算出方法について説明します
少し難しく感じるかもしれませんが 気軽な気持ちで読み進めてくださいね
すでに前処理のレッスンで学習した通り、テキストデータのクリーニングを行ったら、次はテキストの数値化をしてコンピュータが理解できる形式にします。
ここまでのレッスンでは、ワンホットエンコーディングやBag of Wordsによる数値化を行ってきましたが、共起ネットワークでは「共起頻度」や「Jaccard係数(じゃっかーど けいすう)」という手法で数値化を行います。
「共起頻度」や「Jaccard係数」って 難しそうな用語ですが 私でも理解できるんでしょうか…
確かに「数値化」は少し難しい部分もありますし 特に「Jaccard係数」は 数学的な思考が必要になります
ですが ここから先は「こんな風に数値化するんだ」という雰囲気をつかめればそれで問題ありません
共起頻度とは、テキスト内で2つの単語がどのくらいの頻度で一緒に出現するかを表す指標です。
例えば、単語Aと単語Bの共起頻度を計算する場合、テキスト内で単語Aと単語Bが一緒に出現する回数をカウントします。
以下の表にある「肉」「魚」を含んだ文章5件をもとに考えてみましょう。
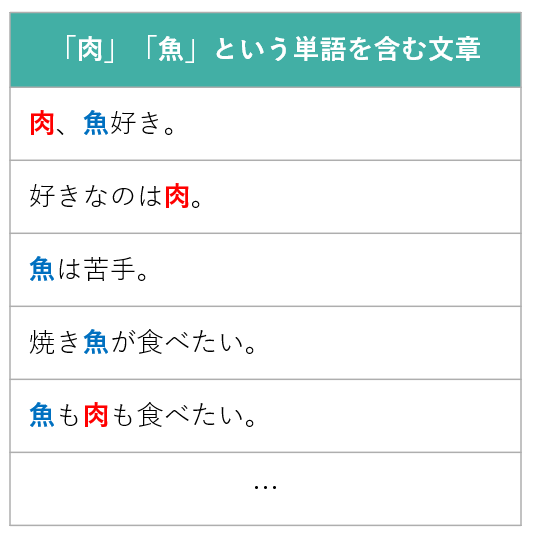
上記のデータでは5つの文章のうち「肉」と「魚」が一緒に出現した文章は「肉、魚好き。」「魚も肉も食べたい。」の2件です。
このことから「肉」と「魚」の共起頻度は「2回」だと分かります。
このように共起頻度による数値化は、直感的に理解しやすいため、このあとのアクティビティでは、この手法を用いて数値化を行った後に、共起ネットワークを作成します。
今回のアクティビティでは使用しませんが、共起ネットワークの生成の際によく利用される数値化の手法に「Jaccard係数」があります。
Jaccard係数とは、ある二つの単語の集合がどれくらい似ているのか、その度合いを表すことで、単語と単語の関連性を導きだす算出方法です。
「集合」とは、その言葉の通り「集まり」を表し、データの集まりを円を使って表します。
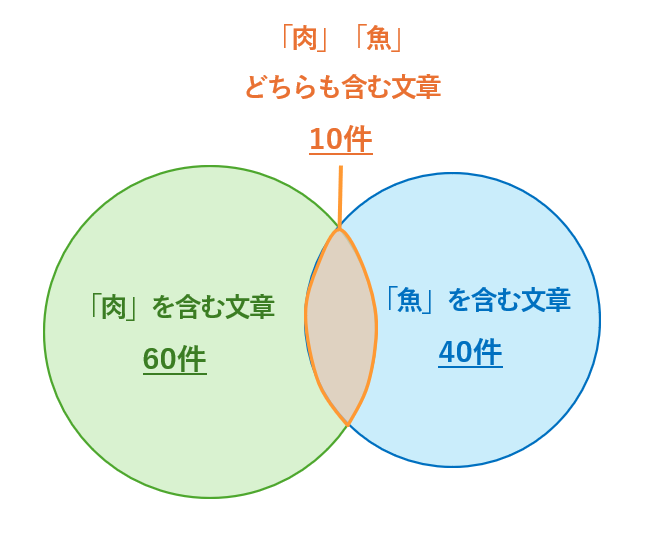
さきほどの「肉」「魚」を含んだ文章が仮に100件に増えたとして、この「集合」について考えてみましょう。
・「肉」だけが出現した文章:60件
・「魚」だけが出現した文章:40件
・「肉」「魚」が一緒に出現した文章:10件
上記の条件を元に、「肉」と「魚」の割合を、「集合」で表すと以下のようになります。
以下の計算式で、Jaccard係数を求めることができます。
「肉」「魚」が一緒に出現した件数 ÷ (「肉」だけが出現した件数 + 「魚」だけが出現した件数 - 「肉」「魚」が一緒に出現した件数)
値を当てはめると、10件 ÷ (60件 + 40件 - 10件)=0.1111… となり、Jaccard係数は約0.1となります。
Jaccard係数の範囲は、「0」~「1」です。0に近いほど関連性が低く、1に近いほど関連性が高いことを表します。
そのため、Jaccard係数が1に近いほど、「肉」と「魚」の関連性が高いと判断することができます。
今回の値は約0.1となり、0に近い値なので「肉」と「魚」の関連性は低いことが分かります。
例えば ある単語がとても高い頻度で出現する場合 共起頻度では ある単語との関連性が過大評価されてしまう可能性がありますが Jaccard係数では 過大評価を抑えることができます
以下の例で「肉」「おいしい」と「肉」「魚」について 共起頻度とJaccard係数を求めて確認してみましょう
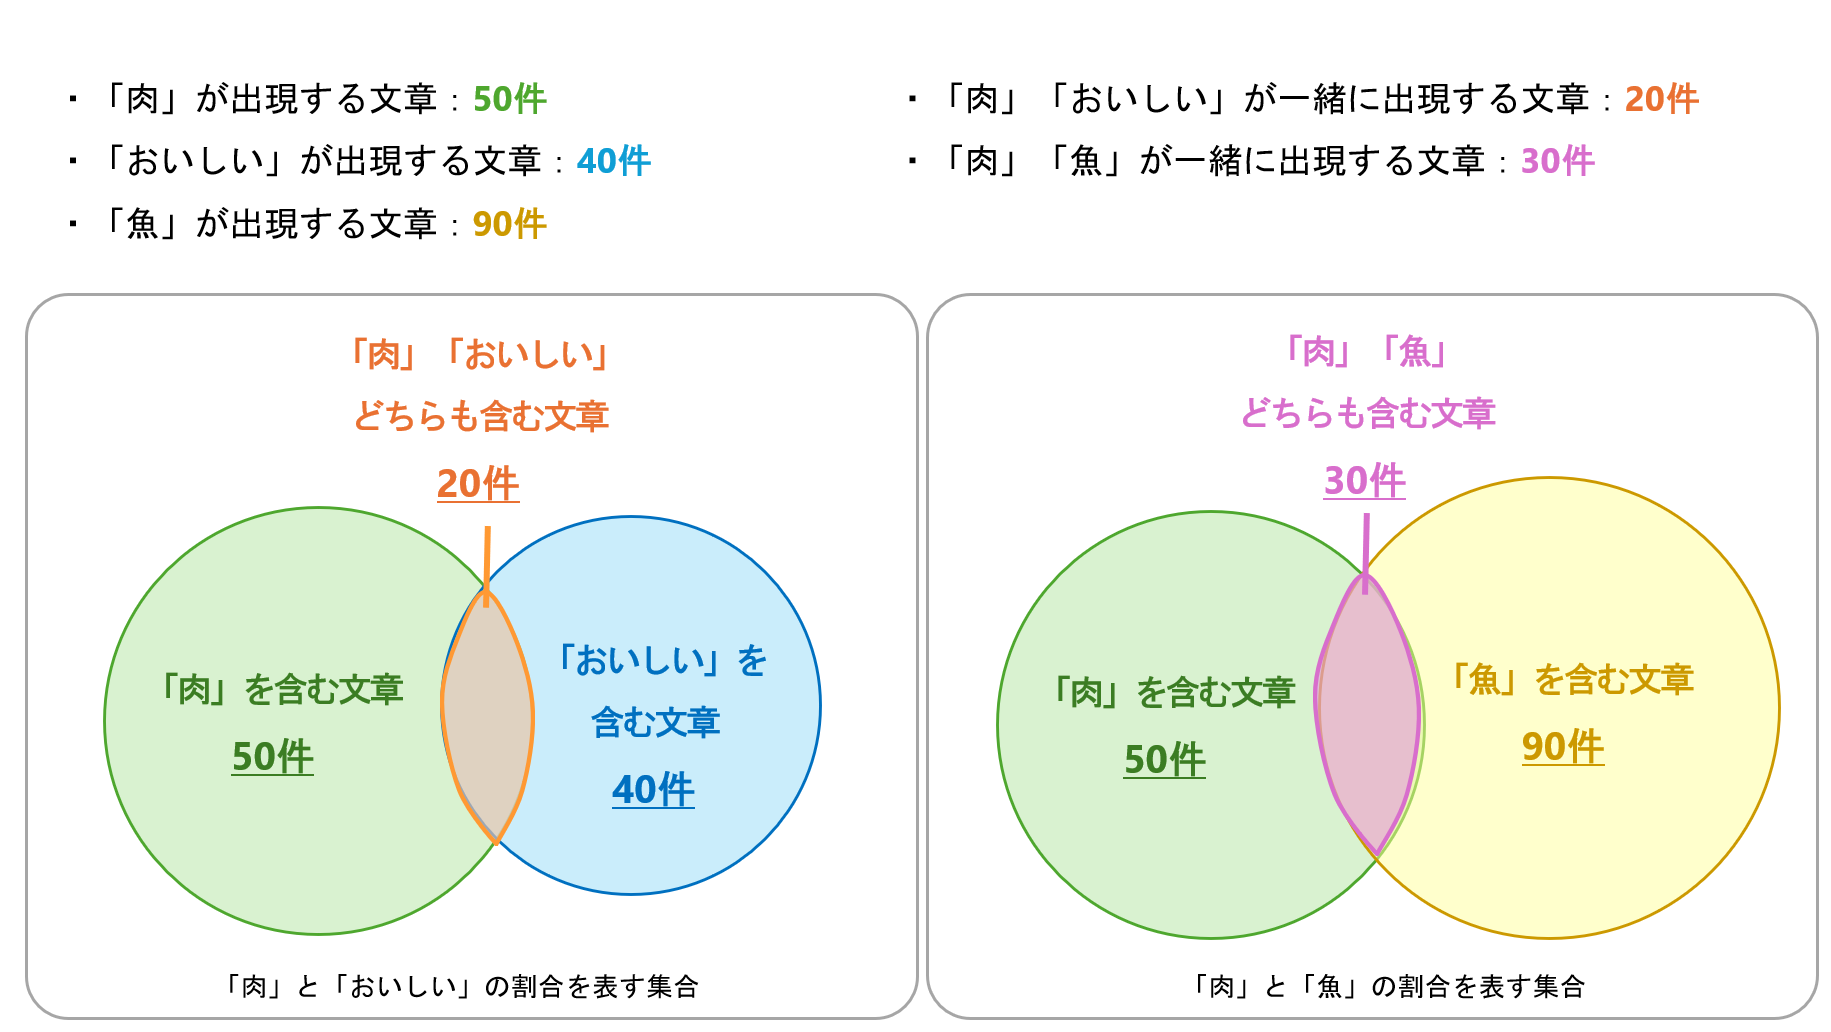
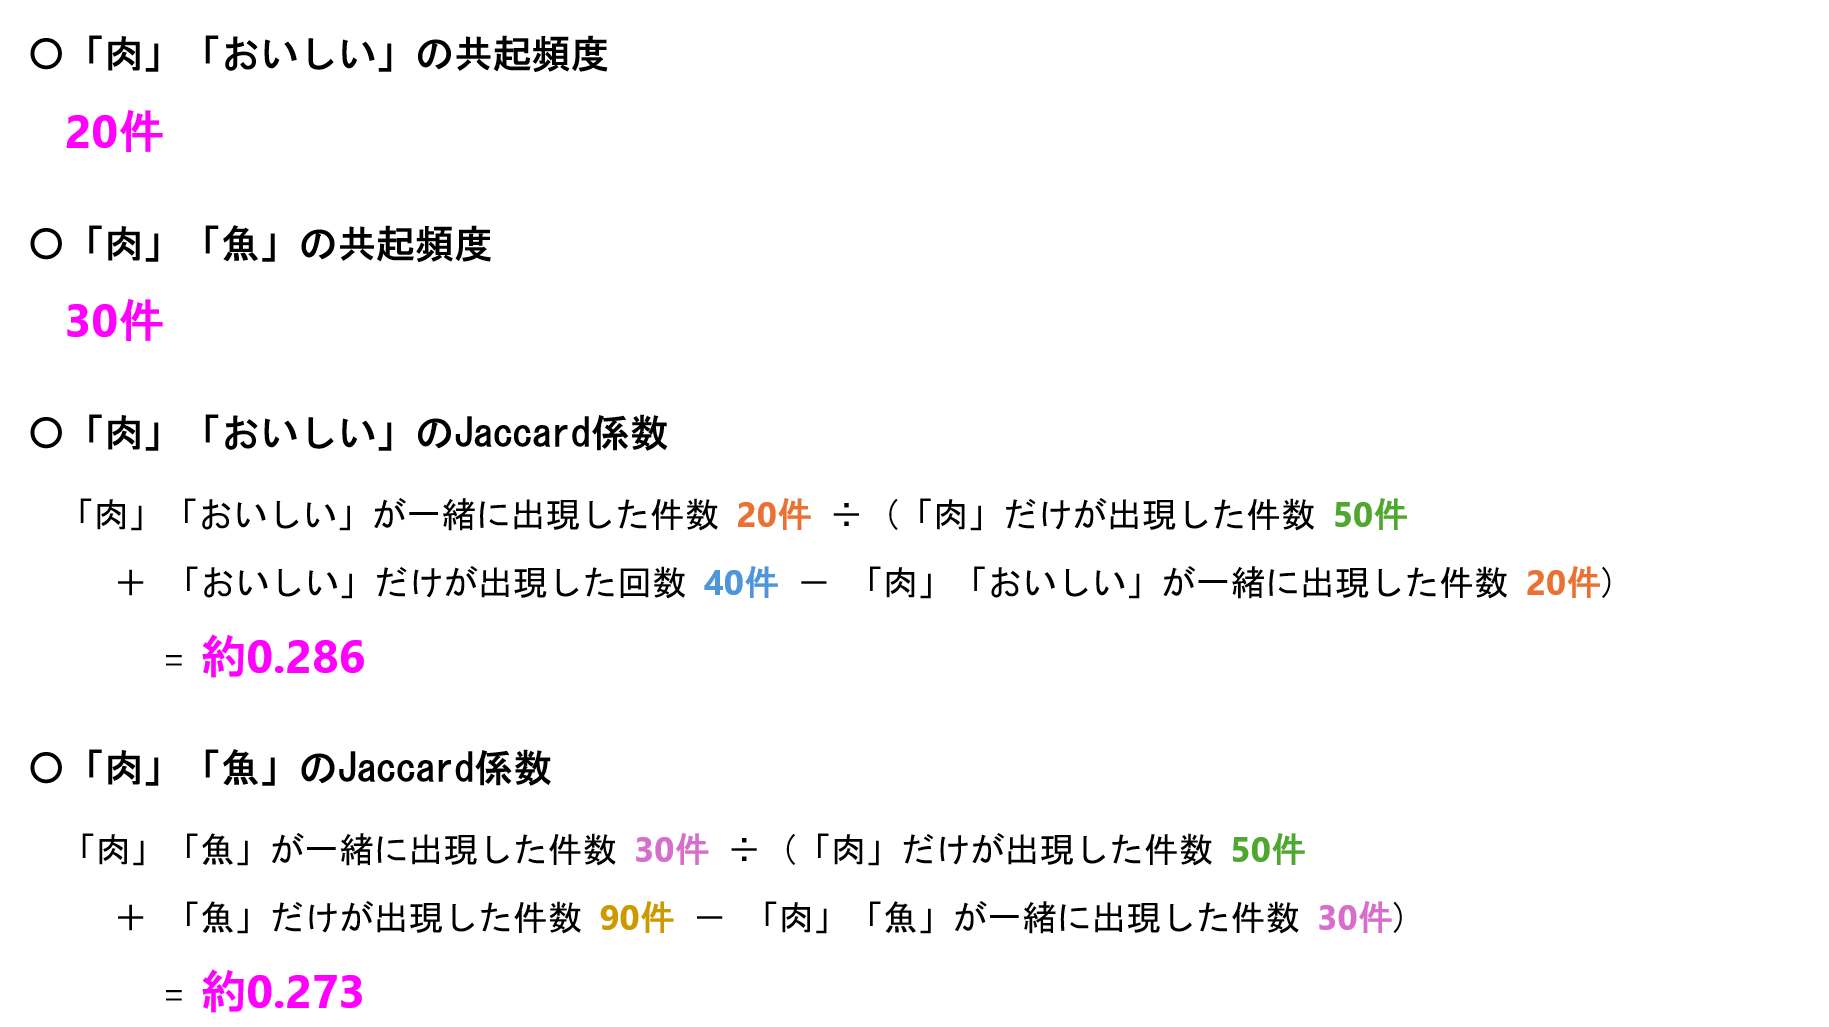
共起頻度だけで見れば「肉」「魚」の組み合わせの方が関連度が高いけど Jaccard係数では「肉」「おいしい」の組み合わせの方が関連度が高くなってるな
このように 共起頻度と比べると Jaccard係数は単語の出現頻度による偏りを考慮できる という利点があります
しかし どちらの方が良いのか とかいう問題ではなく 分析するテキストの特徴や 分析の目的によって どの数値化の手法を使うのか よく考えて選ぶことが大切です

