
須多先生
みなさん こんにちは
本日も一緒に人工知能について学びましょう
2. チャット学習① ( 2 / 13 )

須多先生
みなさん こんにちは
本日も一緒に人工知能について学びましょう
須多先生
前回は 改めてアノテーションについて理解を深めましたね
徳井 天
アノテーションを行うアノテーターによってとらえ方が異なることがあるから 「ルール」を作ったり 話し合うことで どの正解ラベルにするかを決める必要があるんだったよな
深田 あい
間違った正解ラベルを付けてしまうと AIの精度に影響してくるので アノテーションの難しさと重要さを改めて学ぶことができました
須多先生
オンラインショップに届いたテキストデータをクリーニング 数値化して「決定木」を使ってテキスト分類を行いましたね
深田 あい
特に「ネガティブな意見」や「質問や問い合わせ」にはすぐに対応する必要があるので 見逃さないための指標である「再現率」を上げるために色々試したんですよね
須多先生
精度が上がらなかった理由として 「決定木」という シンプルな手法の限界があげられます
須多先生
特に 私たち人間が扱う「言語」は 複雑で多様であるため 決定木だけではその特徴をとらえきれませんでした
徳井 天
決定木以外にもテキスト分類を行う方法が「ディープラーニング」だったよな!今回はその方法を使って分析を行うんですよね 先生!
須多先生
はい 今回は「ディープラーニング」を使った分類方法について学んでいきますよ
「ディープラーニング」での分類については 認識編のレッスンでも習いましたが その時はどんな分類を行ったか覚えていますか?
深田 あい
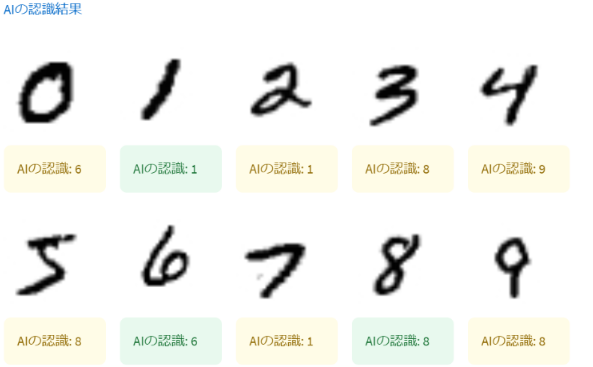
えっと確か 私のおじいちゃんが書いた 手書きの数字の画像を分類するときに ディープラーニングを使いましたよね
徳井 天
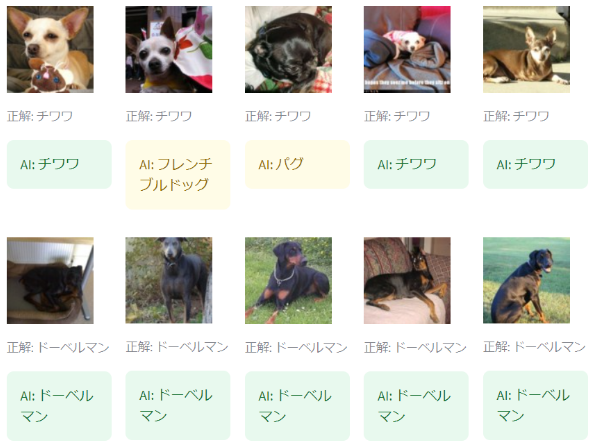
画像に映っている犬種を認識したりもしたよな
どちらも画像を認識させてから分類しているから「画像の分類」になるかな
須多先生
はい その通りです
画像の分類の時と同じように 文章も同じくディープラーニングで分類することができますよ
徳井 天
画像の認識で使ったディープラーニングが 言語でも使用できるって まだいまいちピンときてないんだよな…
深田 あい
私もそうなんだよね
認識編はだいぶ前だったし 復習できると嬉しいんだけどな…
須多先生
それでは 次のスライドで過去の解説動画などを確認しながら 改めてディープラーニングについて振り返りましょう

