
須多先生
みなさん こんにちは
本日も一緒に人工知能について学びましょう
2. チャット学習① ( 2 / 12 )

須多先生
みなさん こんにちは
本日も一緒に人工知能について学びましょう
須多先生
前回は 自然言語処理によるテキスト分析の事例や テキストデータの前処理である データの「クリーニング」や「数値化」について学びましたね
深田 あい
商店街のアンケートの分析にも取り組み始めることができました
改めて ありがとうございます
徳井 天
依頼は アンケートの自由記述部分の分析だったよな
前回は Pythonを使って出現頻度の高い単語を調べたりしたけど えっとその手法を バッグ…オブ…なんだっけ?
徳井 天
そうだ Bag of Wordsだな
それで単語の出現頻度を調べたんだよな
須多先生
文章を単語ごとに分ける「分かち書き」についても学びましたね
分かち書きをする前と後では 出現頻度の結果が異なりましたが 覚えていますか?
深田 あい
「分かち書き」=「単語の分割」ですよね
分かち書きをした後の方が 正確な出現頻度を出すことができましたよね
徳井 天
その出現頻度をグラフ化することで アンケートにどんな単語が多く使われているか より分かりやすくなったんだよな
須多先生
はいその通りです
みなさん しっかり理解できていて素晴らしいですね
深田 あい
ありがとうございます!ところで 今回のレッスンでは どんなことをするんでしょうか?
須多先生
前回はBag of Wordsで単語の出現頻度を数えて それをグラフに表すことで どの単語が何回出現しているかを把握することができました
須多先生
今回は 「WordCloud(ワードクラウド)」という方法で可視化します
グラフとはまた違った方法で 可視化してみますよ
深田 あい
WordCloud(ワードクラウド)ですか
初めて聞く用語ですが どんなことができるんでしょうか?
須多先生
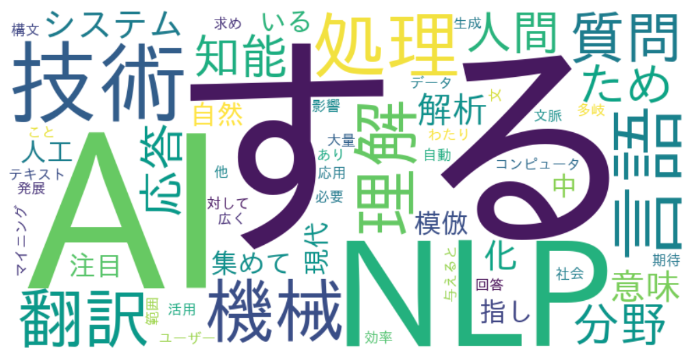
「WordCloud」は 文章の中から単語を選び 出現頻度に応じて単語の大きさを変えながら並べる手法のことを言います
須多先生
出現頻度の高い単語が より文字が大きく表示されるんですよ
徳井 天
大きさが違う色のついた単語が並んでいて なんだか面白そうだな
深田 あい
アンケートの結果がより分かりやすくなりそうですね 早速やってみたいです!
須多先生
それではまずは WordCloudについてのクイズで学びを深め その後 STAR Colabの演習で 実際にWordCloudを作成してみましょう

