
これまで「進化編」のレッスンでは 自ら進化するAI技術である「強化学習」について詳しく学んできました
ここで一度 これまでのレッスンで学んだ「強化学習」の内容について振り返りを行いましょう
9. スライド学習② ( 9 / 14 )

これまで「進化編」のレッスンでは 自ら進化するAI技術である「強化学習」について詳しく学んできました
ここで一度 これまでのレッスンで学んだ「強化学習」の内容について振り返りを行いましょう
強化学習は、AIが試行錯誤を繰り返し、目的を達成する方法を学んで行く技術です。
AIが選択する動作や判断のことを「行動」と言い、それに対して与える評価のことを「報酬」と呼びます。
AI04-03 動画学習「強化学習の『行動』と『報酬』」
ブロック崩しゲームをプレイするAIは、最初はどのようにパドルを動かせばいいか分からず、ランダムに操作していました。
ですが、ボールを打ち返すと得点が増える、落とすとゲームが終わる、といった結果から「良い行動」と「悪い行動」の区別を学んでいきました。
このようにゲームプレイを繰り返すことで、AIは少しずつ「成功する行動」を優先して行い、操作がどんどん上手くなっていく様子を確認しました。
AI04-01 アクティビティ②「ブロック崩しをプレイするAI」
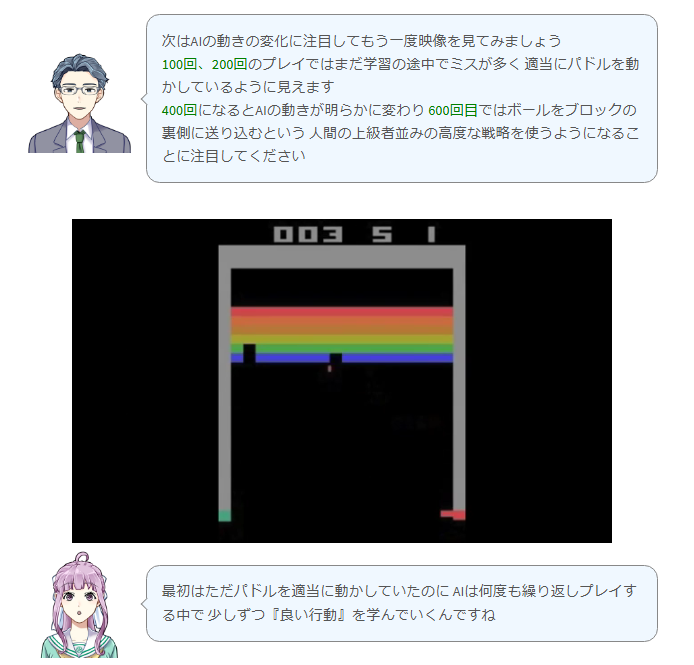
600回プレイしたAIは 人間のプロ並みに上手くなっていたよな
ボードゲームAIでの強化学習の活用として、三目並べを例に学びを深めました。
初めは、「勝利阻止」や「中央優先」などの戦術を「ルールベース」のPythonプログラムで試しましたが、書かなければいけないプログラムが多くなる等、人間が実装するには限界があることを学びました。
そこで、強化学習を活用することで「評価値」をもとに効率的に学習を進めることができ、その結果、ルールが五目に変わってもPythonプログラムの量を増やさずに、AIを学習させることが可能となりました。
AI04-02 アクティビティ②「三目並べの戦術を考えよう」
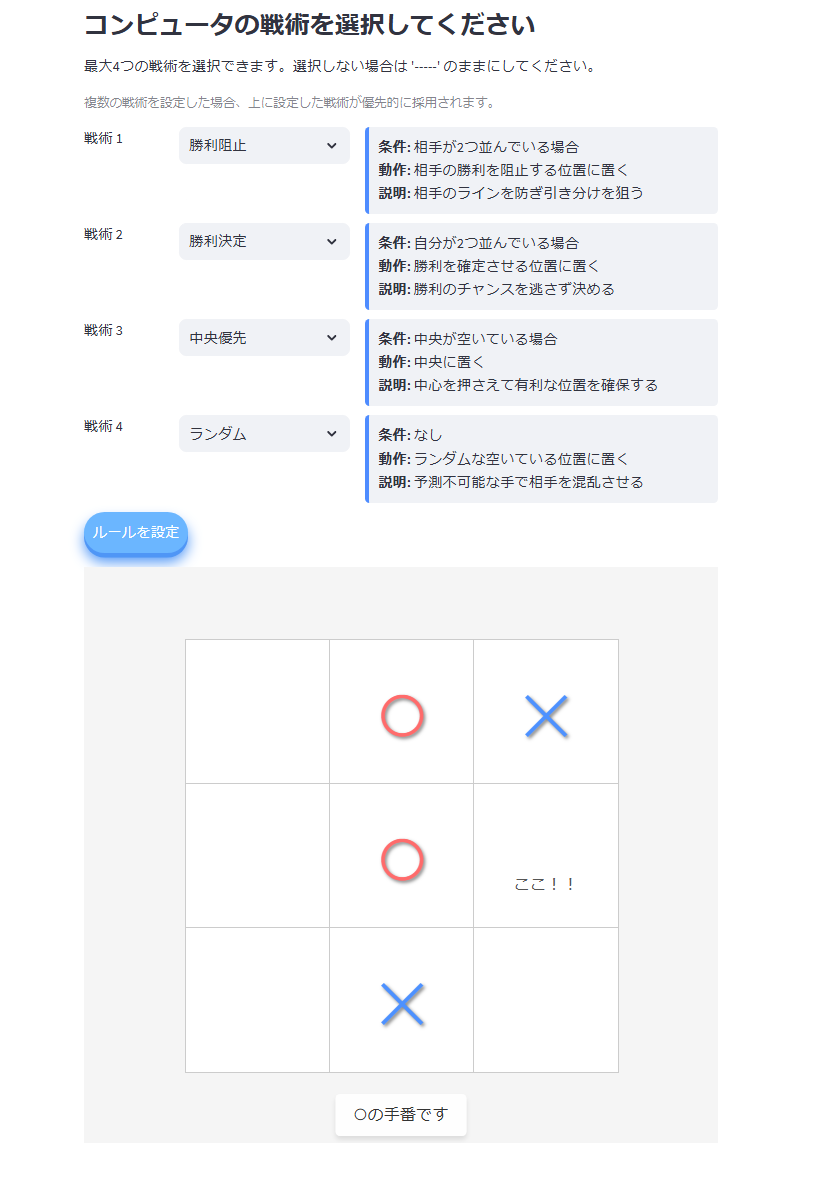
AI04-03 スライド学習①「三目並べの戦術を考えよう」
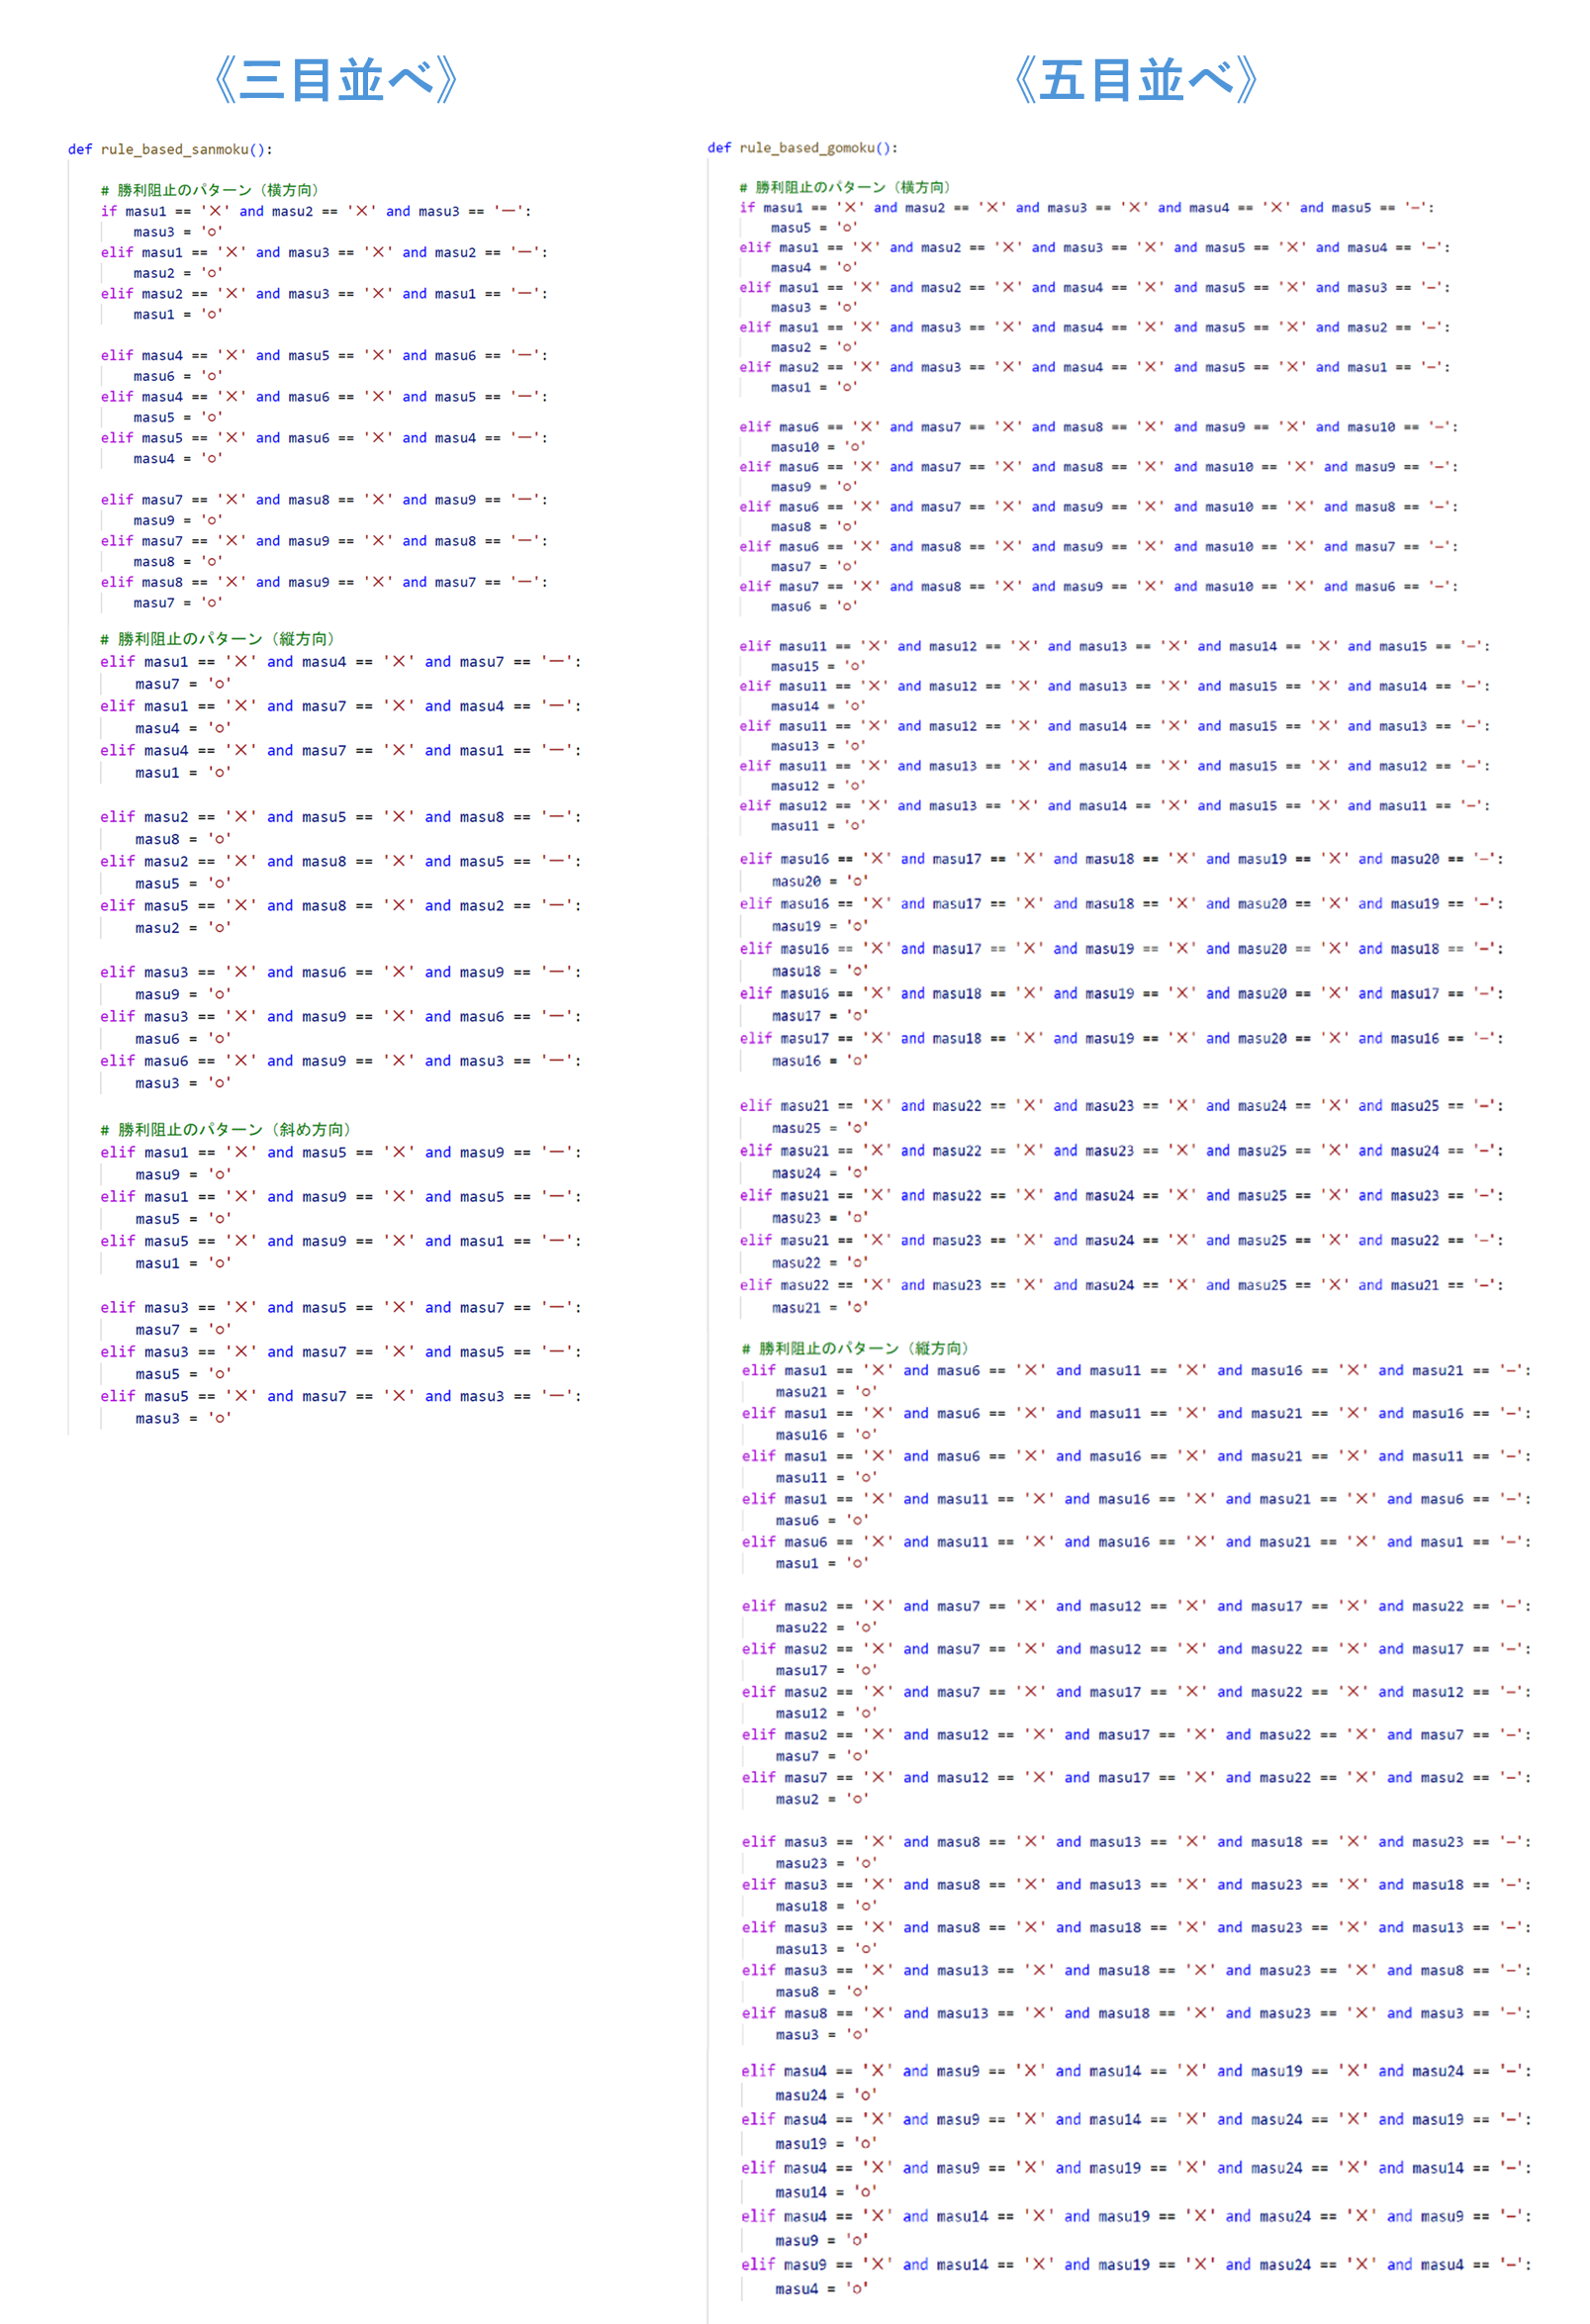
戦術を設定するためのPythonプログラムは 量が多くて読むのも大変だったよね
AI04-03 アクティビティ③「強化学習による三目並べⅡ」
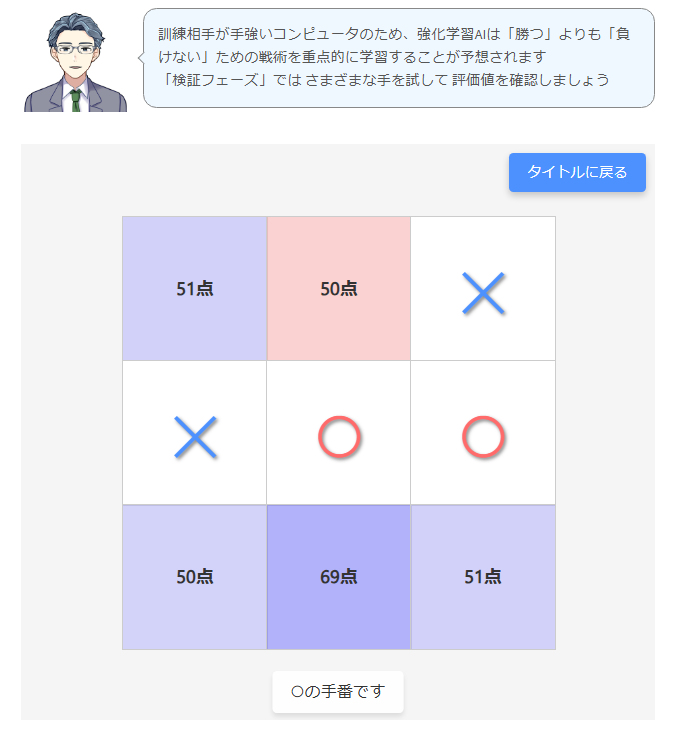
強化学習を使った三目並べをプレイするAIは 「評価値」ってのをもとに石を置く場所を決めていたんだよな
ランダムな手を打つ相手より ルールベースの ある程度強い相手と訓練した方が AIも強くなっていって 上達していく方法が人間に似ているなって思ったんだよな
LLMを使用した生成AIなどの「会話型AI」は、生成された回答に対して、人間が行う「評価」がLLMへの「報酬」となり、その評価をもとに、人間にとって望ましい回答は何かを学習していきます。
さらにLLMは、人間による「報酬」をもとに評価のパターンを学習し、自分自身が生成した回答に対して、自分自身で評価を行い「報酬」を与えるプロセスを繰り返すことで、回答を自己改善していくことを学びました。
AI04-04 スライド学習①「『強化学習』で進化する『会話型AI』の仕組み」
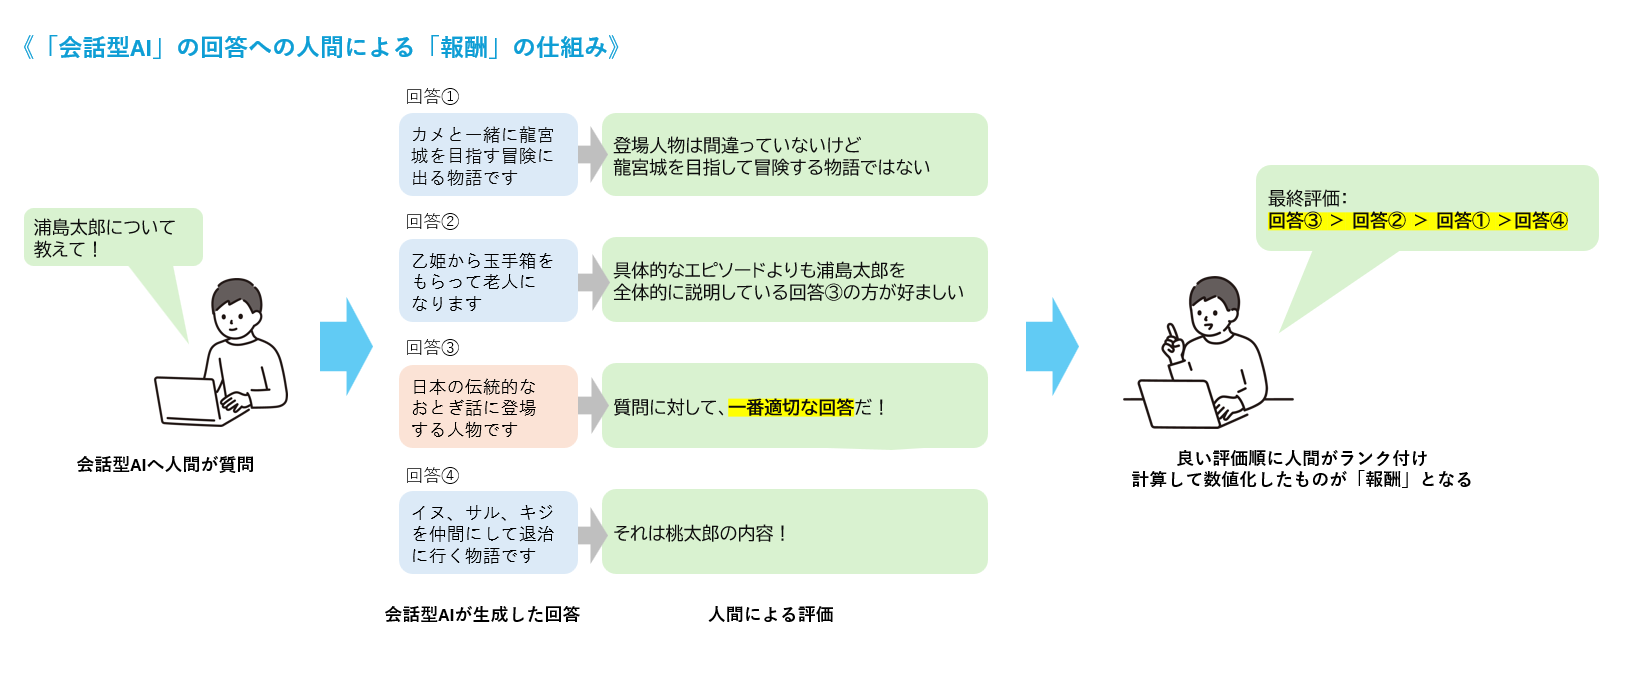
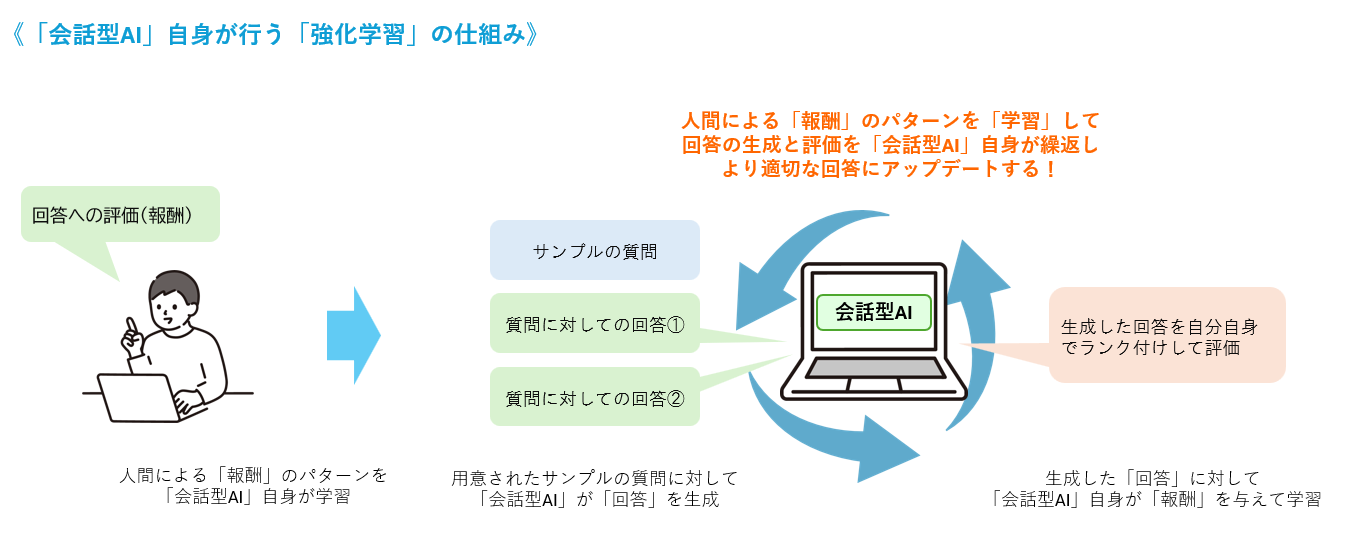
AI04-04 アクティビティ③「強化学習で会話型AIを育てる」
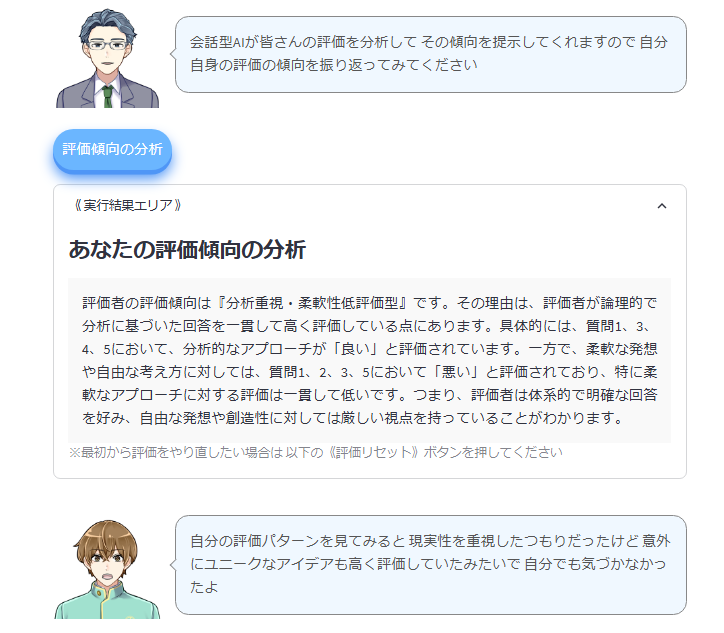
LLMの回答に対して 評価を行う人のことを「ヒューマンエバリュエーター」って呼んだよね
演習で実際に評価を行ってみたら 自分好みの回答をするLLMを作ることができたよね
自動運転技術では、車が走行する環境を正しく認識し、交通ルールを守って適切な行動を取れるようにするために、強化学習が利用されています。
他の車両とぶつからずに走行できたら「プラスの報酬」、赤信号を無視して進んだら「マイナスの報酬」などの報酬を与えることで、行動のパターンを学習し、より安全な運転を目指して学習を行うことを学びました。
AI04-05 アクティビティ②「強化学習による自動運転に挑戦」
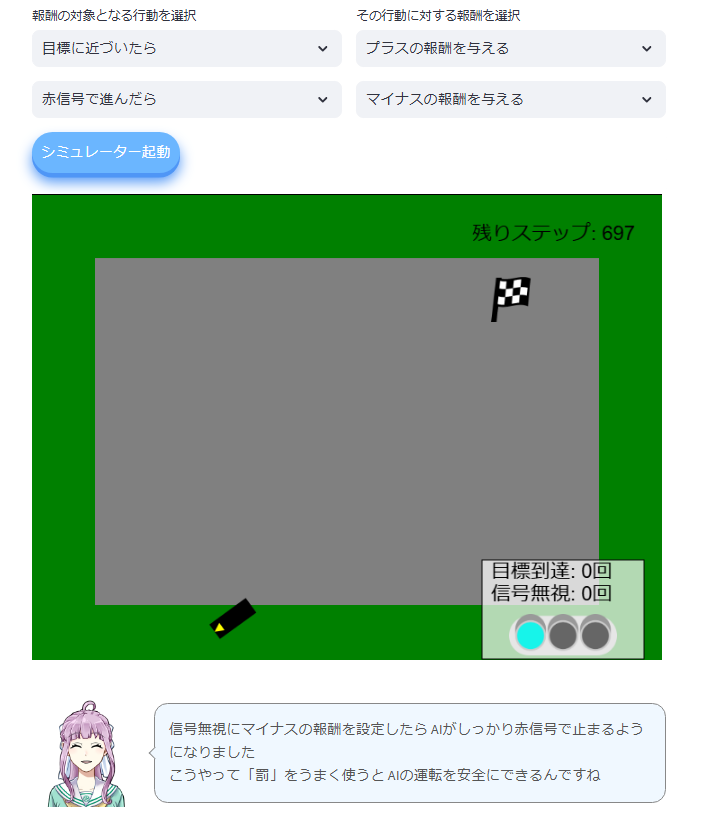
まだまだ先の 未来の技術だと思っていた自動運転車が 俺たちの身の回りで活躍しているってことに驚いたんだよな
強化学習の技術は、私たちの生活を支える産業でも活躍の幅を広げています。
演習では、「ロボットアーム」を例に、荷物を正しくつかむ、指令された場所に運ぶ、といった動作に対して与えた「報酬」をもとに、学習を進める様子を確認しました。
AI04-06 アクティビティ②「強化学習によるロボットアーム操作」
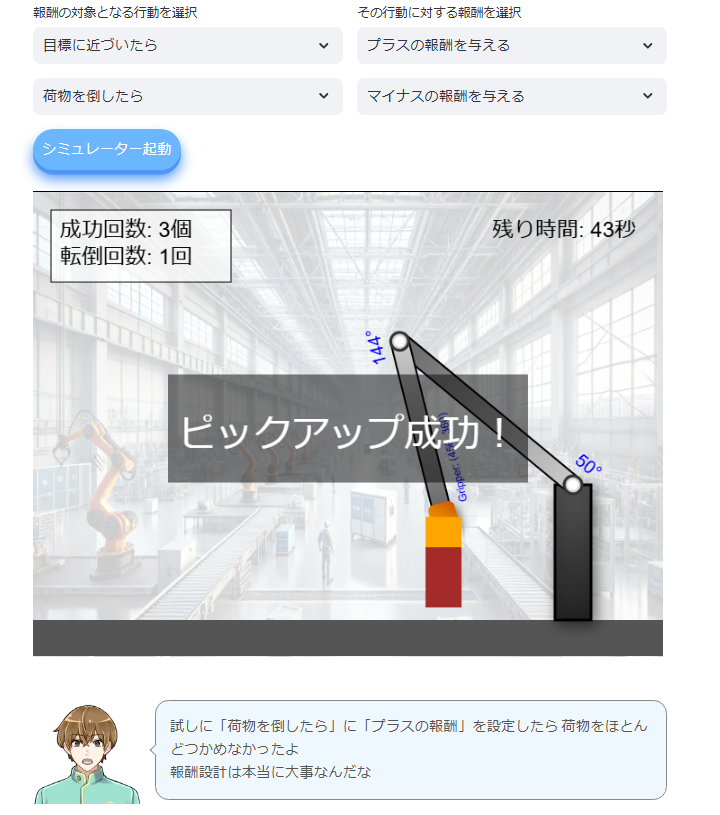
さっきの演習でやったロボットアームのことだね
荷物を倒さないように しっかり指定された場所にアームの先端を移動させるよう 上手に学習できていたよね
これまでのレッスンで学んできた 自ら進化するAIである「強化学習」について おさらいできましたか?

