
ここまで、東京23区のデータを使って分析を行ってきました。
まず、e-Statの人口データと、コンビニ出店数データを結合しました。
その後、グラフや散布図を使って、区ごとの特徴を確認しました。
情報活用編プラス
第6章「IT技術を使って問題解決をしよう」
IP05-04
問題解決をしよう② コンビニ出店はどこにする?
7. ✏️分析 ~コンビニ出店はどこが有利?~ ( 7 / 10 )

学習の目的
1.これまで考察したデータを振り返る
2.複数のデータを組み合わせて考える
3.「出店に向いている区」を自分で考察する
4.データ分析の限界についても考える
ここまで、東京23区のデータを使って分析を行ってきました。
まず、e-Statの人口データと、コンビニ出店数データを結合しました。
その後、グラフや散布図を使って、区ごとの特徴を確認しました。
・総人口が多い区ほど、コンビニ出店数も多い傾向があった
・昼間人口とコンビニ出店数には、さらに強い関係が見られた
・高齢化率とコンビニ出店数には、強い関係は見られにくかった
「人口が多い場所」より、「昼に人が集まる場所」のほうが重要そうでしたね。
はい。特に、オフィス街や駅周辺では、昼間人口が大きく増えるため、コンビニの需要も高くなると考えられます。
ここで考えたいのは、「どの区ならコンビニ出店に向いていそうか」です。
ただし、単純に「人口が多い区」を選べばよいわけではありません。
例えば、次のような視点も重要になります。
・昼間人口が多いか
・すでにコンビニが多すぎないか
・今後も人が集まりそうか
・住宅街なのか、オフィス街なのか
・高齢者向けサービスの需要がありそうか
つまり、データ分析では、「1つの数字だけ」で決めるのではなく、複数の視点を組み合わせて考える必要があります。
同じ「人口が多い区」でも、街の特徴はかなり違いそうですね。
その通りです。例えば、オフィス街と住宅街では、コンビニが利用される時間帯も違うかもしれません。
次に、「人口や昼間人口のわりに、コンビニが少ない区」に注目してみましょう。
このような区は、「まだ出店の余地がある可能性」があります。
もう一度、総人口順とコンビニ出店数順を比較してみましょう。
merged.sort_values(
    "総人口(人)",
    ascending=False
)[["区名", "総人口(人)", "コンビニ出店数"]]
実行結果
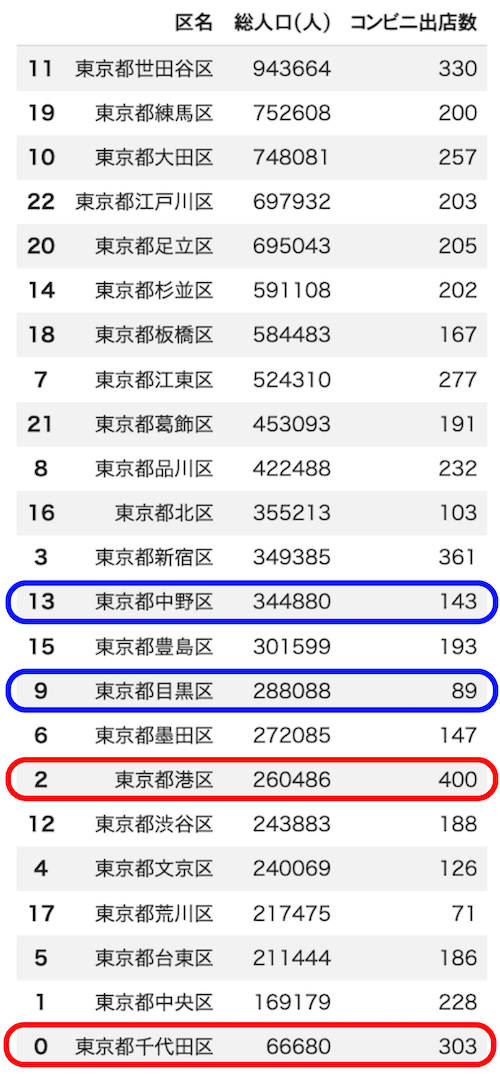
さきほど見たように、港区や千代田区などは、昼間人口が非常に多い地域です。
そのため、「住んでいる人」より、「昼に集まる人」の影響が大きいと考えられます。
だから、人口ランキングだけでは見えなかった特徴が出てくるんですね。
逆に、中野区や目黒区は人口のわりにコンビニ数が少なめに見えます。
そのように、「人口に対して多いのか少ないのか」を比較することで、新しい特徴が見えてきます。
データ分析では、単純なランキングを見るだけでなく、「なぜその差があるのか」を考えることが重要です。
数字を並べるだけじゃなく、背景を考えるのが分析なんですね。
また、昼間人口でも確認してみましょう。
merged.sort_values(
    "昼間人口(人)",
    ascending=False
)[["区名", "昼間人口(人)", "コンビニ出店数"]]
実行結果
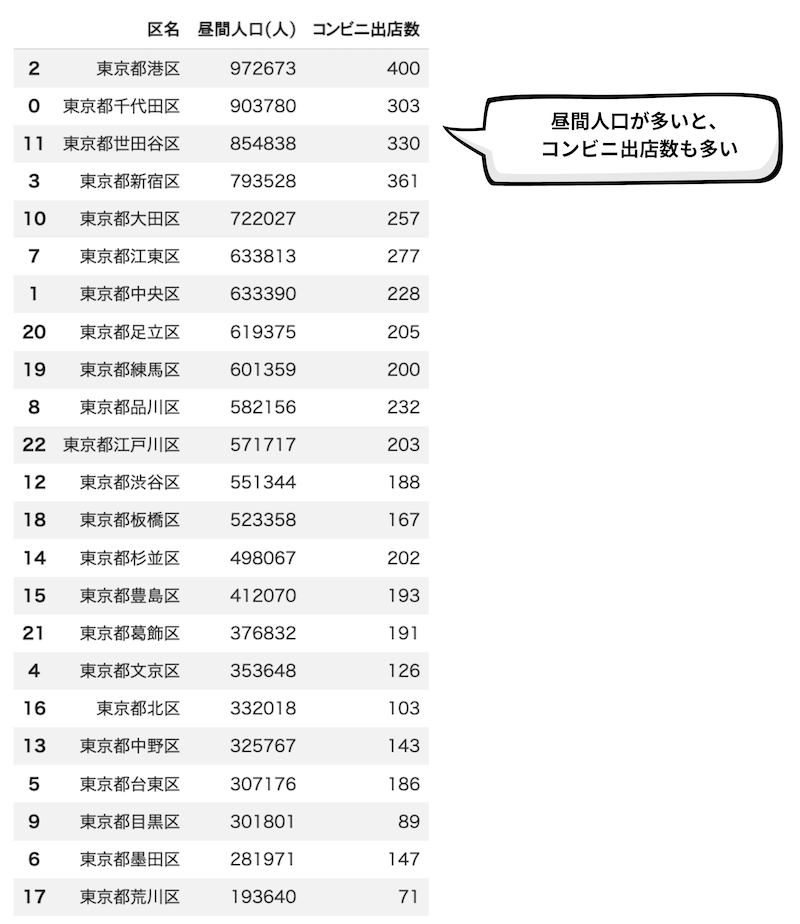
表を比較すると、「人は多いのに、コンビニ出店数はそれほど多くない区」が見つかるかもしれません。
さきほど確認したように、港区や千代田区では、昼間人口が非常に多くなっています。
オフィス街では、通勤や昼休みで多くの人が集まるため、コンビニ需要も高くなると考えられます。
でも、中央区は昼間人口がかなり多いわりに、コンビニ出店数はそこまで多くないですね。
良い視点です。そのような区は、「まだ出店の余地がある」と考えることもできます。
逆に、すでにコンビニが多い区は、競争が激しい可能性もあります。
「人が多い場所」を探すだけじゃなく、「まだ少ない場所」を探すのも大切なんですね。
ここで、「一定人数あたり、どのくらいコンビニがあるか」を考えてみます。
これは、「コンビニが多いか少ないか」を比較しやすくするためです。
今回は、「10万人あたりのコンビニ出店数」を計算してみましょう。
merged["10万人あたりコンビニ出店数"] = (
    merged["コンビニ出店数"]
    / merged["総人口(人)"]
) * 100000

merged
実行結果
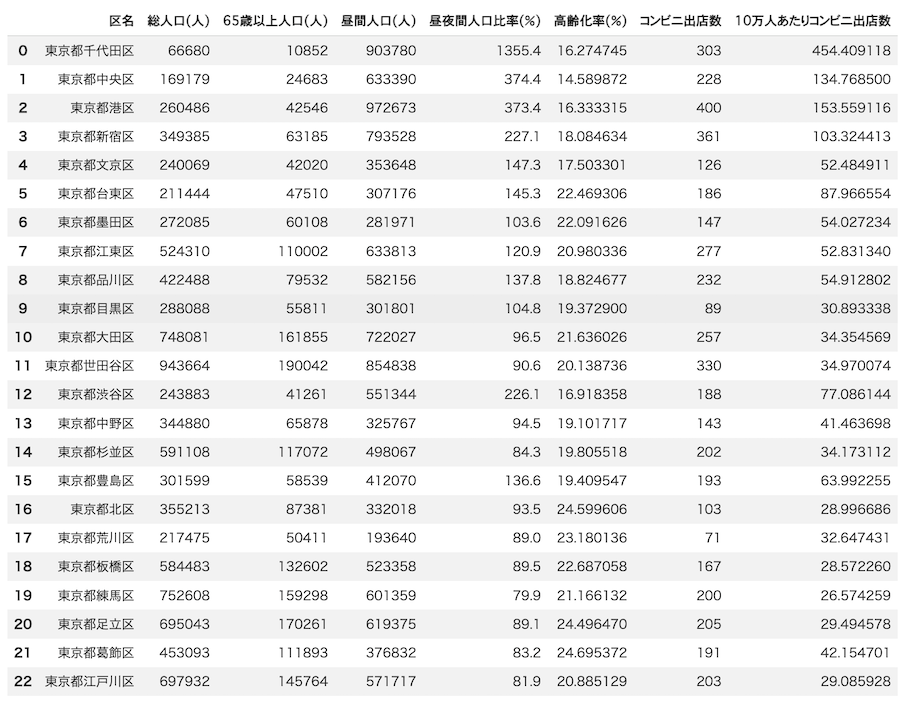
新しい列を追加することで、単純なコンビニ出店数だけでは見えなかった特徴が見えてきます。
例えば、人口が少なくても、コンビニ密度が高い区があるかもしれません。
計算した結果を並べ替えてみましょう。
merged.sort_values(
    "10万人あたりコンビニ出店数",
    ascending=False
)[["区名", "10万人あたりコンビニ出店数"]]
実行結果
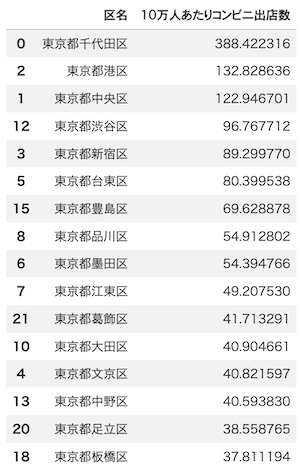
「コンビニ出店数」だけじゃなく、「人口に対してどれくらいあるか」を見るのも大事なんですね。
はい。データ分析では、「割合」に変換すると見えやすくなることがよくあります。
先ほどは、総人口を使って、10万人あたりのコンビニ出店数を求めました。
しかし、これまでの分析では、コンビニ出店数は「総人口」よりも「昼間人口」との関係が強そうでした。
そこで今度は、昼間人口10万人あたりのコンビニ出店数を求めてみましょう。
昼間人口10万人あたりのコンビニ出店数を計算する列を追加してください。
列名は、「昼間人口10万人あたりコンビニ出店数」としてください。
また、その結果を大きい順に並べ替えて確認し、一番多い区名を答えてください。
先ほどのコードでは、次のようにして新しい列を追加しました。
merged["10万人あたりコンビニ出店数"] = (
    merged["コンビニ出店数"]
    / merged["総人口(人)"]
) * 100000
今回は、このコードのうち、主に次の2か所を変更します。
① 新しく作る列名
"10万人あたりコンビニ出店数" → "昼間人口10万人あたりコンビニ出店数"
② 割り算に使う人口の列
"総人口(人)" → "昼間人口(人)"
並べ替えでも、同じ列名を使う必要があります。
列名を少しでも間違えると、エラーになるので注意しましょう。
コードを何度も実行して混乱した場合は、Google Colabのメニューから、すべてのセルを最初から実行し直すと整理できます。
また、列名を間違えて追加してしまった場合も、ノートブックを最初から実行し直すと、正しい状態に戻しやすくなります。
総人口を基準にした場合と比べて、順位に違いが出るか確認してみましょう。
もし順位が変わった場合は、「総人口」と「昼間人口」のどちらを重視するかで、分析結果が変わる可能性があります。
ここまで、人口・昼間人口・高齢化率・コンビニ出店数を使って分析してきました。
しかし、実際の出店判断では、さらに多くの情報が必要になります。
・駅の数
・観光客の多さ
・オフィスの数
・ライバル店の位置
・土地代や家賃
・道路や人の流れ
つまり、今回の分析だけで「絶対にこの区が正解」とは言えません。
データ分析では、データを使って「可能性」を考えることが重要です。
データだけで全部決まるわけではないんですね。
はい。だからこそ、データを参考にしながら、人が考えて判断することが重要なんです。
問題
あなたがコンビニ会社の出店担当者だとします。
ここまで分析したデータを使って、「新しくコンビニを出店するなら、どの区が有力候補になるか」を考えてください。
また、次の内容を含めて説明してください。
・選んだ区名
・その区を選んだ理由
最大 200 文字
・どのデータを重視したか
・不安な点や不足している情報
最大 200 文字
「人口が多い」だけでなく、「昼間人口」「コンビニ密度」「すでにコンビニが多すぎないか」など、複数の視点を組み合わせて考えてみましょう。
今回の学習では、実際の統計データを使いながら、データ分析の流れを体験しました。
・CSVデータをPythonで読み込む方法
・複数のデータを結合する方法
・グラフや散布図でデータを可視化する方法
・データ同士の関係を考察する方法
・データ分析には限界もあること
実際のデータを使うと、かなり本格的な分析ができるんですね。
はい。今回行った流れは、実際のデータ分析でも基本となる考え方です。
数字を見るだけじゃなく、「なぜそうなるのか」を考えるのが面白かったです。
※この再現版では提出は行いません(送信先は未接続です)

