

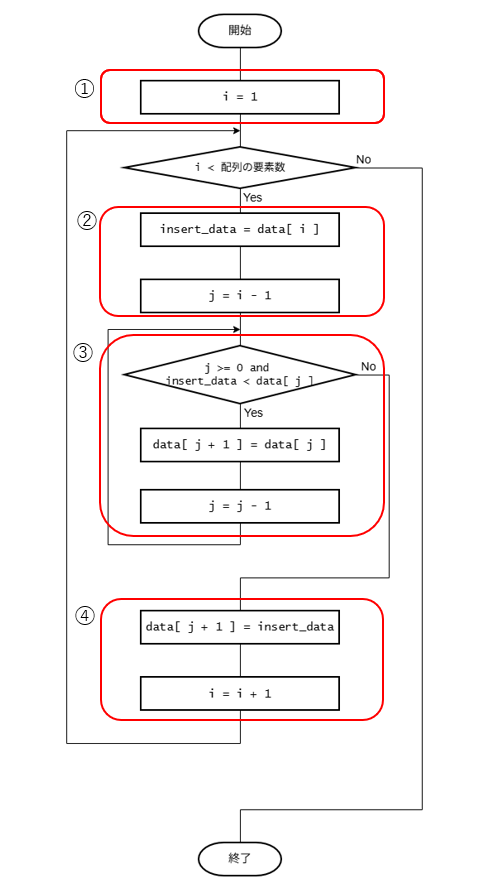
挿入法のフローチャートは次のようになります。
処理は大きく分けて4つの処理に大別されます。
挿入法の処理は4つに大別されます。
- ① 挿入するデータの添字の初期設定
- ② 挿入位置を探索するための前処理
- ③ 挿入位置を探索する処理
- ④ 挿入処理
① 挿入するデータの添字の初期設定
データの挿入は添字1番(2件めのデータ)のデータから行われます。
変数iは挿入するデータの添字のため、最初の値は1になります。
i = 1
② 挿入位置を探索するための前処理
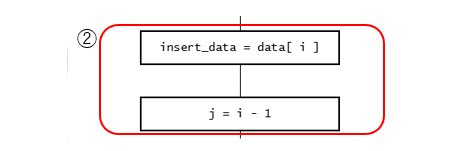
②は③で行う挿入位置を探索する処理の前処理です。
前処理では挿入データの退避と挿入位置の探索開始位置の設定を行います。
・挿入データの退避
変数insert_dataは挿入データを退避するための変数です。
退避処理は次の命令で行います。
insert_data = data[ i ]
・挿入位置の探索開始位置の設定
挿入位置の探索は
整列済みデータの右端から行います。
挿入される i 番目のデータの直前まで、データが整列済みです。
そのため、開始位置は「i - 1」番目になります。
探索は変数 j で位置を指定するため次の命令で行います。
j = i - 1
③ 挿入位置を探索する処理
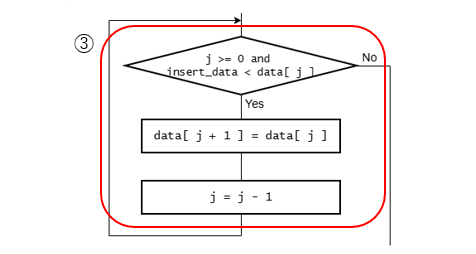
挿入位置を探索します。
重要な点は配列データを移動させながら挿入位置を探索することです。
ここでは、
・繰り返し条件
・データの移動処理
・次のデータへの添字の更新処理
が行われます。
・繰り返し条件
繰り返しの条件は2つです。
- 挿入データが配列のデータより小さいとき(insert_data < data[ j ] )
- 配列の比較位置が配列の先頭でない
繰り返しの条件は次のようになります。
j >= 0 and insert_data < data[ j ]
・データの移動処理
挿入法では、データを入れる場所を作るために、すでにあるデータを
1つ右にずらしていきます。
これにより、挿入する位置に空きを作ります。
データを移動する命令は次のようになります。
data[ j + 1 ] = data[ j ]
・次のデータへの添字の更新処理
データを移動したあとは、次のデータを比較するために添字を更新します。
添字を更新する命令は次のようになります。
j = j - 1
④ 挿入処理
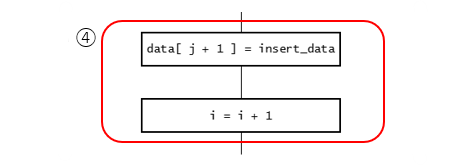
データの挿入と次のデータの挿入のための添字更新処理を行います。
・データの挿入処理
繰り返しが終了したときには、添字 j には、
挿入データより小さいデータの添字位置
が格納されています。データはその1つ右側の要素位置に格納されます。
なお、すべてのデータより小さい場合(j が
-1 になるとき)は、
先頭(data[0])に挿入します。
データを移動する命令は次のようになります。
data[ j + 1 ] = insert_data
・次の挿入のための添字の更新処理
データを挿入したあとは、次のデータを挿入するために添字を更新します。
挿入するデータを表す添字は i なので命令は次のようになります。
i = i + 1
交換法や選択法と違って交換する処理がないんですね。
いいところに気づきましたね。データの交換を行うとそれだけで3命令の実行が必要でした。
挿入法は、データの交換がなくデータの移動も1命令なのでその分、実行する命令数が少なくなります。
なるほど、それだけでも効率が良さそうですね。Pythonで並べ替えをしてこれまでよりどのくらい速いのか比べてみたいです。
それでは早速Pythonのプログラムを作成しましょう。

