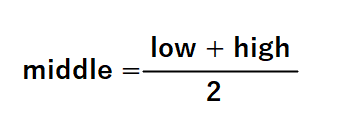二分探索のアルゴリズム

学習の目的

  • 1. 二分探索のアルゴリズム

  • 2. フローチャートの空欄を埋めよう

1. 二分探索のアルゴリズム

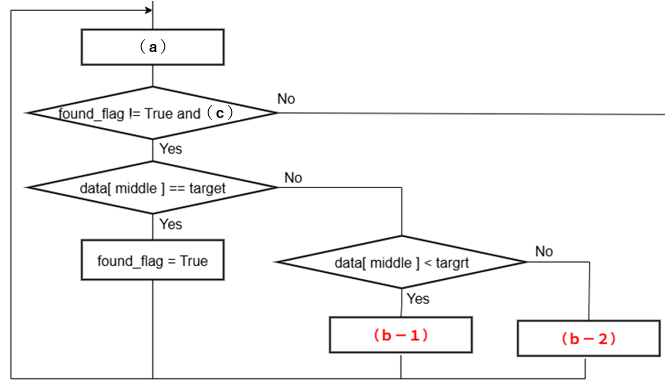
二分探索のフローチャートは次のようになります。

二分探索のフローチャート
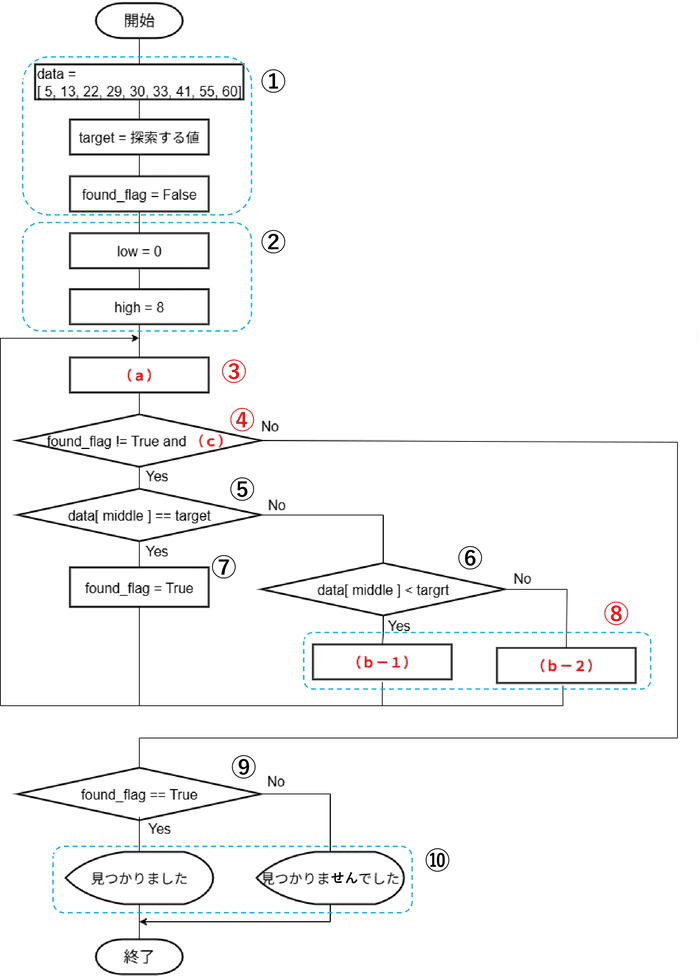
二分探索の処理手順は次の4つの処理に分けることができます。

  • 1 初期設定処理
  • 2 繰り返し処理
  • 3 探索処理
  • 4 表示処理

二分探索のアルゴリズムを処理単位ごとに確認します。

1 初期設定処理

初期設定処理では、①、②で二分探索に必要な初期設定を行います。

① 配列dataと探索値targetの設定、発見フラグfound_flagの設定
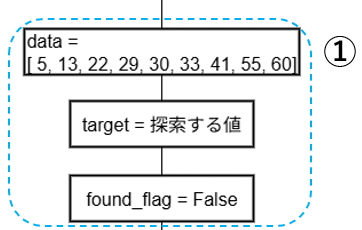
二分探索を行うために必要な変数の設定を行います。

data:探索する配列。昇順にデータが格納されている。

target:探索値。

found_flag:探索の状態を保持。見つかっていない場合はFalse、見つかった場合はTrueが入る。

② 探索範囲を表すlowとhighの設定
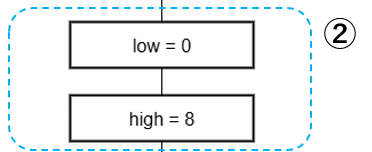
探索範囲を変数lowとhighで表します。

lowは範囲の最小の添字、highは範囲の最大の添字を代入します。

low:探索範囲の最小の添字。初期値は0。

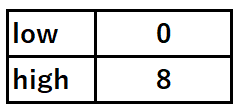
high:探索範囲の最大の添字。初期値は配列の要素数-1。今回は8を設定。


2 繰り返し処理

繰り返し処理では、③、④で二分探索の繰り返しの制御を行います。
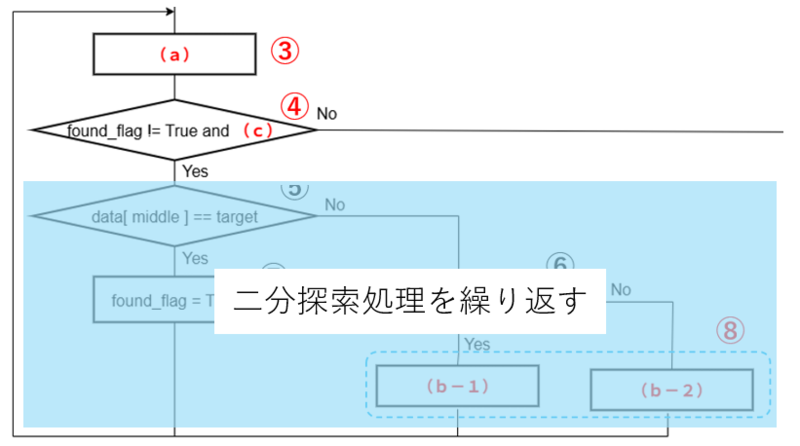
③ 探索範囲の中央の位置を計算する

探索範囲の中間位置を計算します。

詳しい説明は後述します。

④ 繰り返し処理の条件

繰り返し処理の条件を記述します。

繰り返しを続ける条件は以下の2つの条件が成立している間です。

  • found_flag != True : データが見つからない間
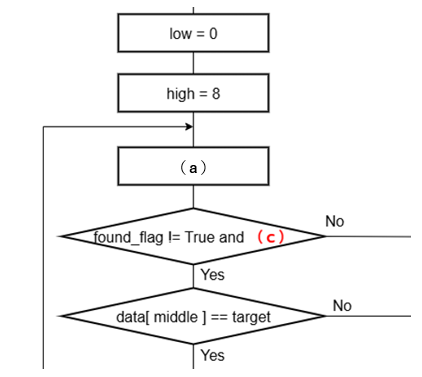
  • (c):詳しくは後述します。

3 探索処理

探索処理では、⑤~⑧で探索値と配列の要素を比較して、探索値が見つかるか調べます。
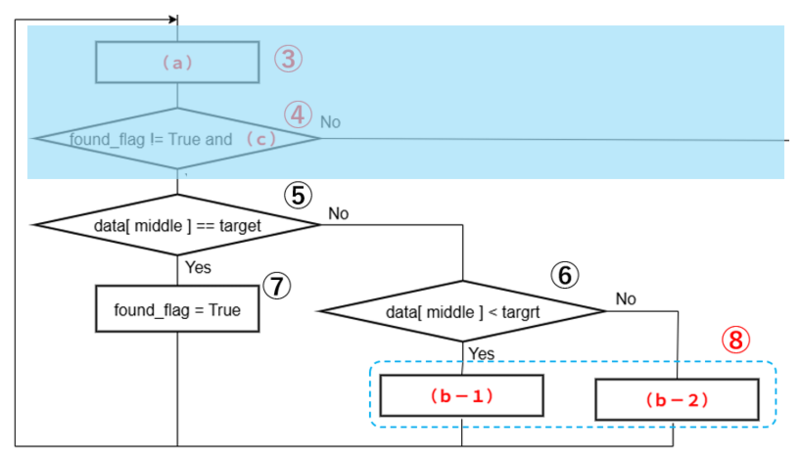
⑤ 比較処理

探索値と同じデータか比較して判定します。

同じデータであれば⑦へ進みます。

異なるデータであれば、新しく探索範囲の設定を行うため⑥へ移動します。

⑥ 探索範囲の判定

探索値と比較した配列の要素の値の大小関係を調べ、
次の探索範囲が現在よりも左側なのか右側なのかを判定します。

⑧でlowもしくはhighの値を変更することで探索範囲の更新をします。

⑦ 発見フラグの設定

⑤の判定で探索データが見つかった場合の処理です。
変数「found_flag」にTrueを代入し、探索値が見つかった状態にします。

⑧ 探索範囲の更新

探索範囲を再設定するためにlowとhighの値の更新をします。

詳細は後述します。


4 表示処理
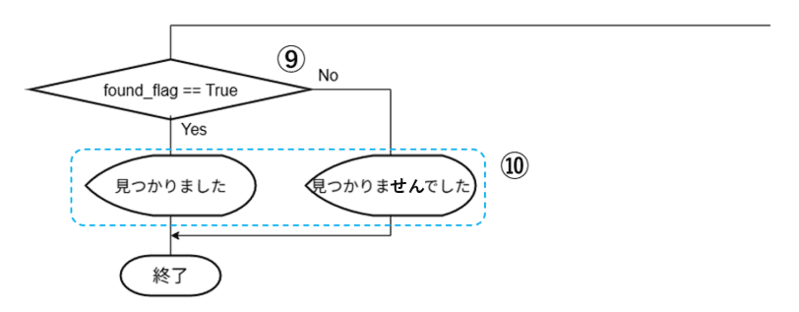
表示処理では、⑨、⑩で、探索値が見つかった場合と見つからなかった場合で表示内容を変えています。

⑨ 探索データが見つかったかどうかの判定

探索データが見つかったかどうかで表示内容を変えるための処理です。

表示処理は⑩で行います。

⑩ 結果の表示処理

データが見つかった場合:「見つかりました」と表示する。

データが見つからなかった場合:「見つかりませんでした」と表示する。

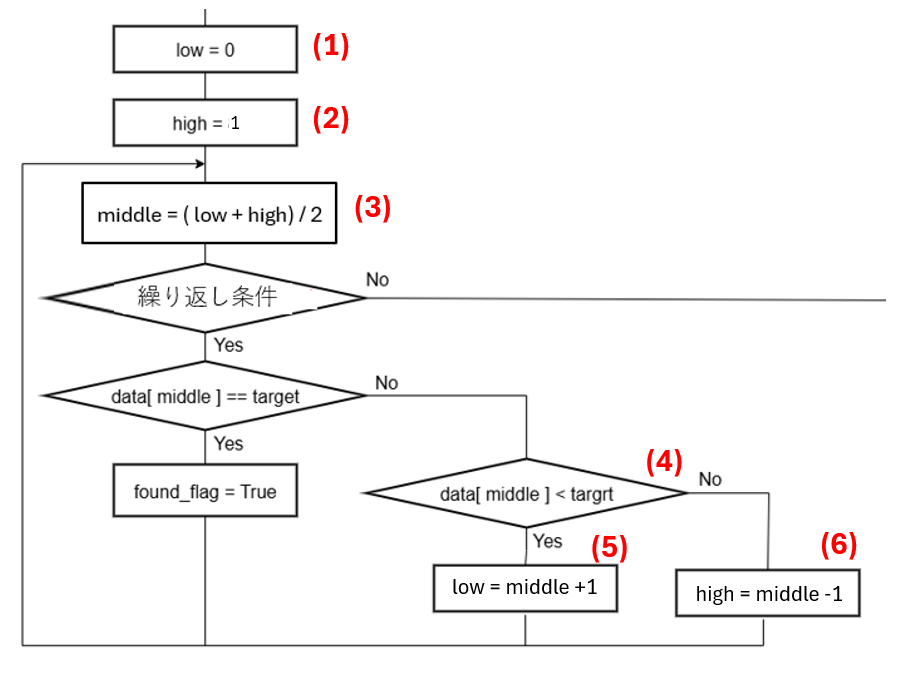
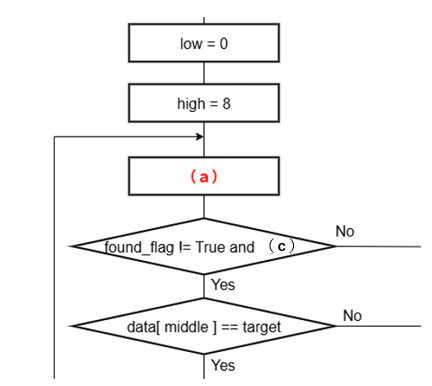
上のフローチャートには(a)、(b-1)、(b-2)、(c)の4か所の空欄があります。
3つとも二分探索処理を行うときには重要なところなので、一つずつ何が入るか確認していきます。
2. フローチャートの空欄を埋めよう

空欄(a): 探索範囲の中央の添字を求める

二分探索で比較する要素の添字位置を求めるには、配列の探索範囲の最小の添字位置の値と最大の添字位置の値を使って計算して求めます。

次の変数で2つの値を管理することとします。

変数名 説明
low 探索対象配列の最小の添字位置が格納される変数。初期値は0。
high 探索対象配列の最大の添字位置が格納される変数。初期値は「配列の要素数 - 1」。

次の配列の場合、lowとhighにはどのような値が入るでしょうか?

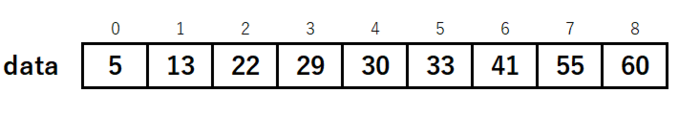
要素数9の配列dataを使って二分探索を行います。

変数lowと変数highにはどのような値が最初に入るでしょうか?

lowは配列の最小の添字だから 0 で、highは一番大きい添字の値だから 8 かな

そうですね。lowとhighは次のようになります。

lowとhighを使って中央の位置の計算ができます。

どう計算すればよいかわかりますか?

中央だから、lowとhighを足して2で割れば良いんじゃない?

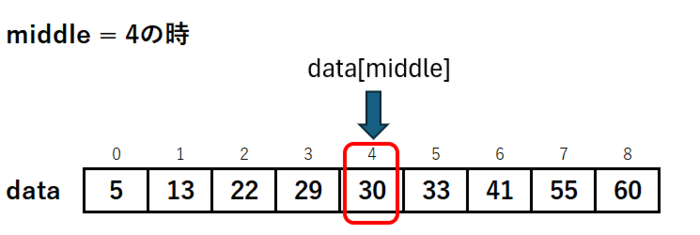
正解です!中央の添字を表す変数を middle とすると次のように計算することができます。

中央の添字位置を求める計算式

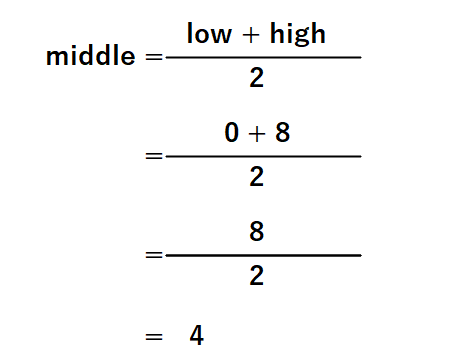
この計算式に当てはめると、次のように計算できます。

middleを配列の添字として使うことで、配列の中央の要素を指定します。

なるほど!中央の位置は計算で求められるのか。よくわかりました。

空欄(a)に入る処理を下記の一覧から選んで答えてください。

middle = low + high
middle = low / high
middle = (low +  high) / 2
middle = (low + high) * 2

空欄(b-1)、(b-2): 次の探索範囲を決める

(b)は次の探索のために探索範囲を更新するための処理が入ります。

探索範囲は次の条件によって2通りの更新が行われます。

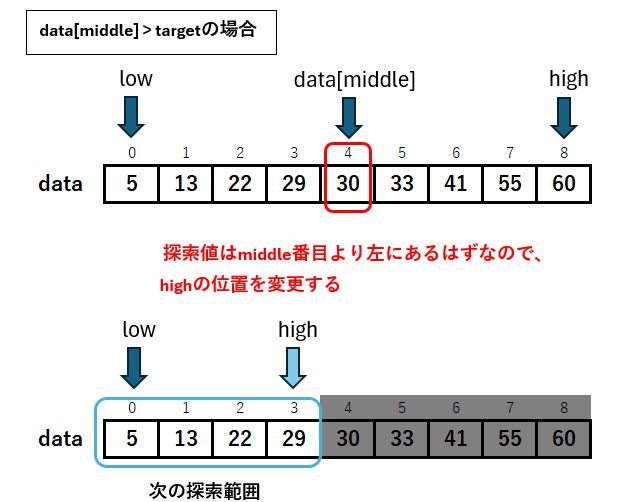
  • 条件1:data[ middle ] > target → 探索データは中央より小さいので、探索値は中央値より左側にある。
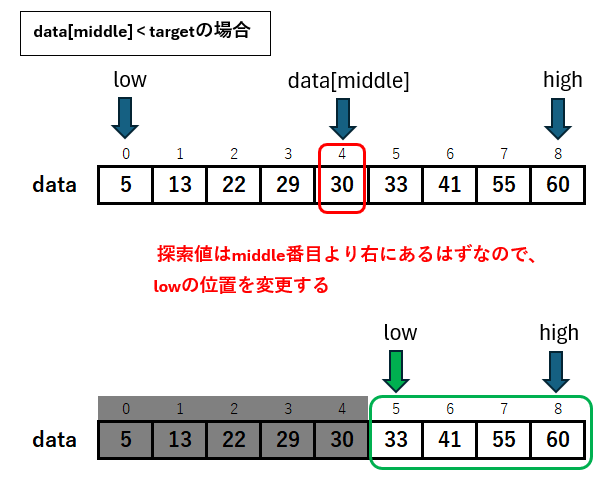
  • 条件2:data[ middle ] < target → 探索データは中央より大きいので、探索値は中央値より右側にある。

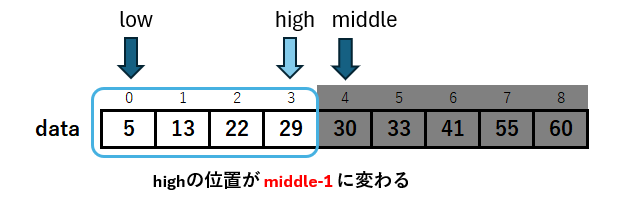
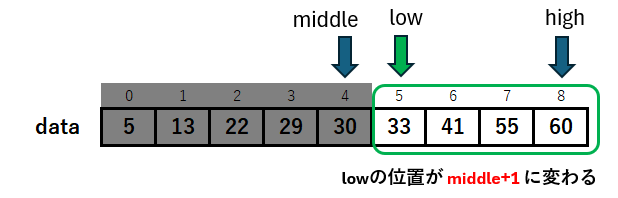
図で表すと次のようになります。

条件1

条件2

ポイントは次の点です。

  • 探索範囲を小さい方(左側)に変更する場合:変数highの値を変更する。
  • 探索範囲を大きい方(右側)に変更する場合:変数lowの値を変更する。

例えば、探索値が 13 、最初の中央の値は 30 の場合はどうなりますか?

探索値 13 の方が小さいので、中央の位置より小さい左側を探せば良いってことだから、highの値を変えるってことですね?

そうです。育人くん、変数highには何を入れますか?

えっ!

えーっと、図を見るとmiddleの左側がhighだから「middle - 1」ですか?

すごい!よくできました。data[middle]はすでに確認したので、middle番目を範囲に含めることはありません。

まとめると次のようになります。

data[ middle ] > target のとき:highの位置が middle - 1に変わる。

data[ middle ] < target のとき:lowの位置が middle + 1に変わる。

空欄(b-1)と(b-2)に入る処理を下記の一覧から選んで答えてください。

low = middle + 1
low = middlw - 1
high = high + 1
high = high - 1

(b-1)に入る処理を答えてください。

(b-2)に入る処理を答えてください。

空欄(c): データが存在しない場合に繰り返しを終了する条件を決める

フローチャートで記述されている繰り返しの条件は「found_flag != True」です。

フローチャートで記述されている繰り返しの条件は「found_flag != True」です。

これは、どういう時を表してますか?

found_flag は、見つかったときTrue,見つかっていないときFalseなので、「Trueでない」という条件だから見つかっていないときに繰り返すっていう条件です。

そうです。よく理解していますね。

線形探索のときは、繰り返しの条件が2つありました。二分探索も同じように繰り返しの条件は2つあります。

あっ!わかりました。

最後までデータを確認しても見つからなかったら繰り返しをやめなければいけないですよね。

でも、どうやって最後のデータって判断するんだろう?

線形探索のときは、先頭から順番に比較するので、最後のデータがわかりました。

二分探索は順番に比較しないので最後のデータは単純にはわかりません。どうやれば最後のデータが分かるか学習しましょう。

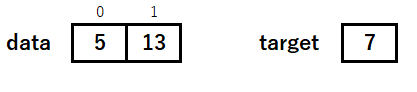
配列の要素数が2の場合を例に、二分探索でデータが見つからなかったときのケースを考えます。

要素数2の場合の例

配列data:探索元のデータ。データ数は2個。
target: 探索するデータ。7なので配列dataには存在しない。

このときに、フローチャート通りに二分探索をした場合、どのように変数が変わっていくか確認します。

次の表は抜粋したフローチャートを実行したときの変数の値がどのように変わっていくかを表しています。

処理番号 処理内容 low high middle 説明
(1) low = 0 0 ー ー 変数lowに配列の最小の添字を代入する
(2) high = 1 0 1 ー 変数highに配列の最大の添字を代入する
(3) middle = (low + high) / 2 0 1 0 middleの位置を計算する
(0 + 1) / 2 = 0
(4) data[ middle ] < target 0 1 0 data[0]が5、targetが7なので条件は成立し(5)の処理を行う
(5) low = middle + 1 1 1 0 探索範囲の更新のため、lowにmiddle + 1を代入し(3)へ移動する
(3) middle = (low + high) / 2 1 1 1 middleの位置を計算する
(1 + 1) / 2 = 1
(4) data[ middle ] < target 1 1 1 data[1]が13、targetが7なので条件は成立しないため(6)の処理を行う
(6) high = middle - 1 1 0 1 探索範囲の更新ため、highにmiddle - 1を代入し(3)へ移動する

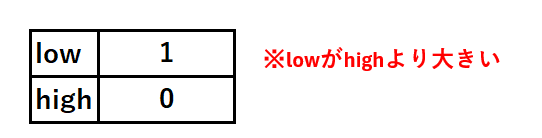
表の最終行の変数lowとhighの値には次のような値が入っています。

あれ?lowは探索範囲の一番小さい添字位置、highは探索範囲の一番大きい添字位置だったはずなのに、lowのほうが大きい値が入っている。

通常では起こらない状態になっています。この状態が配列にデータが見つからなかった状態を表しています。

そうなんだ。じゃあ、この状態になったら繰り返しを終わればよいのですね?

そうです。空欄(c)はその条件を記入します。

空欄(c)に入る処理を下記の一覧から選んで答えてください。

low < high
low <= high
low > high
low >= high

※この再現版では提出は行いません(送信先は未接続です)

Well done!

次のステップに進みましょう!

次のステップに進む

← 前のステップにもどる