
このスライドでは VLM(Vision-Language Model:ビジョンランゲージモデル)について詳しく学んでいきましょう
3. スライド学習① ( 3 / 11 )

VLM(Vision-Language Model:ビジョンランゲージモデル)とは
VLM(Vision-Language Model:ビジョンランゲージモデル)とは?
VLMとは、「Vision-Language Model(ビジョンランゲージモデル)」の略で、画像と文章を組み合わせて理解し活用する生成AIの一種です。
例えば、写真やイラストをVLMに入力すると、その内容を説明するテキストを生成することができます。
VLMの機能を持つ生成AIサービスに、以下のように画像を入力し、「この画像には何が映っていますか?」と質問すると、画像に何が映っているかを認識し、文章で回答が返ってきます。
ChatGPTを使用した例
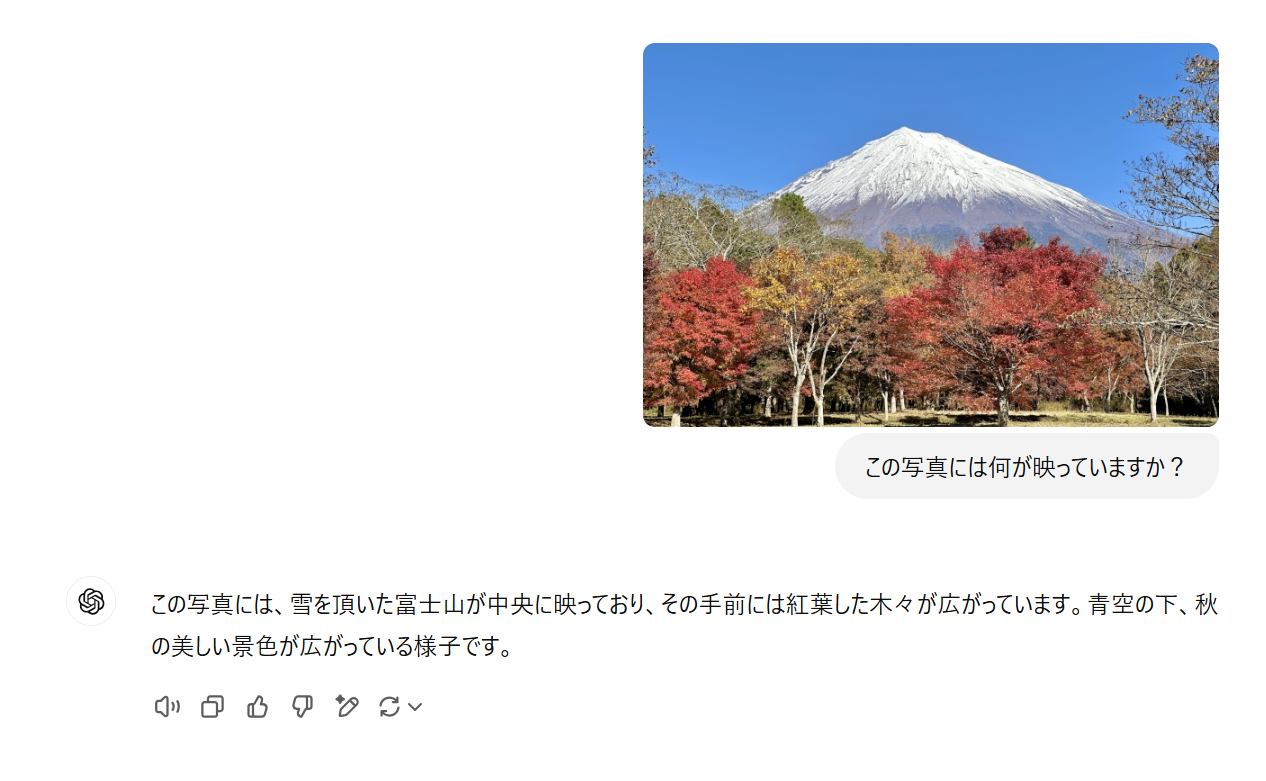
VLMは 画像認識の技術と LLM(大規模言語モデル)を使ったテキスト生成の技術を組み合わせることで 「視覚情報」と「言語情報」を同時に処理することができます
これまでに学んだ知識を組み合わせて VLMが実現しているってことですね
VLMの仕組み
VLMは、以下の手順で画像と文章を組み合わせて理解します。
1.事前学習
まず初めにAIは、画像とテキストがセットになっている大量のデータを使って、学習を行います。
例えば、草原で犬とリンゴが映る画像と、「草原、犬、リンゴ」というテキストがセットになっています。
この段階ではまだ、画像のどの部分に、何が映っているか、などの、画像に映る物体とテキストの関連付けはされていません。
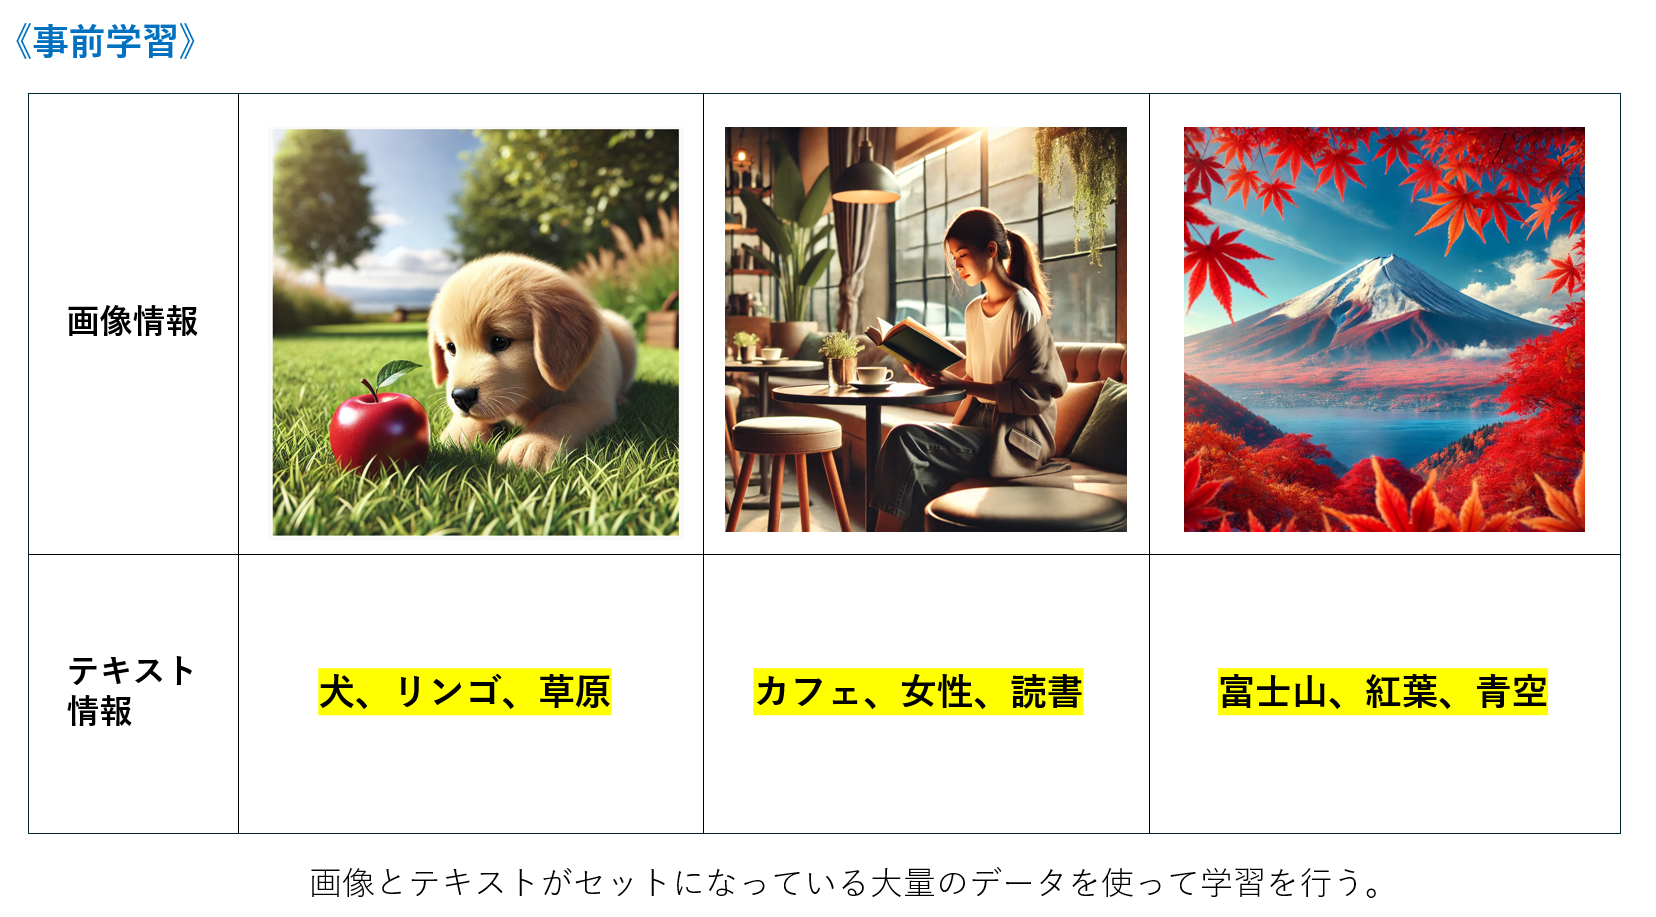
AIが 画像とテキストをセットで学習する過程が「事前学習」なんだな
2.画像の特徴の抽出
次に「画像に何が映っているか」等の特徴の抽出を行います。
これにより、画像のどの部分にどのような物体が映っているかを認識します。
この手順は、人間の「目」の役割を果たし、AIが画像を理解するための第一歩になります。
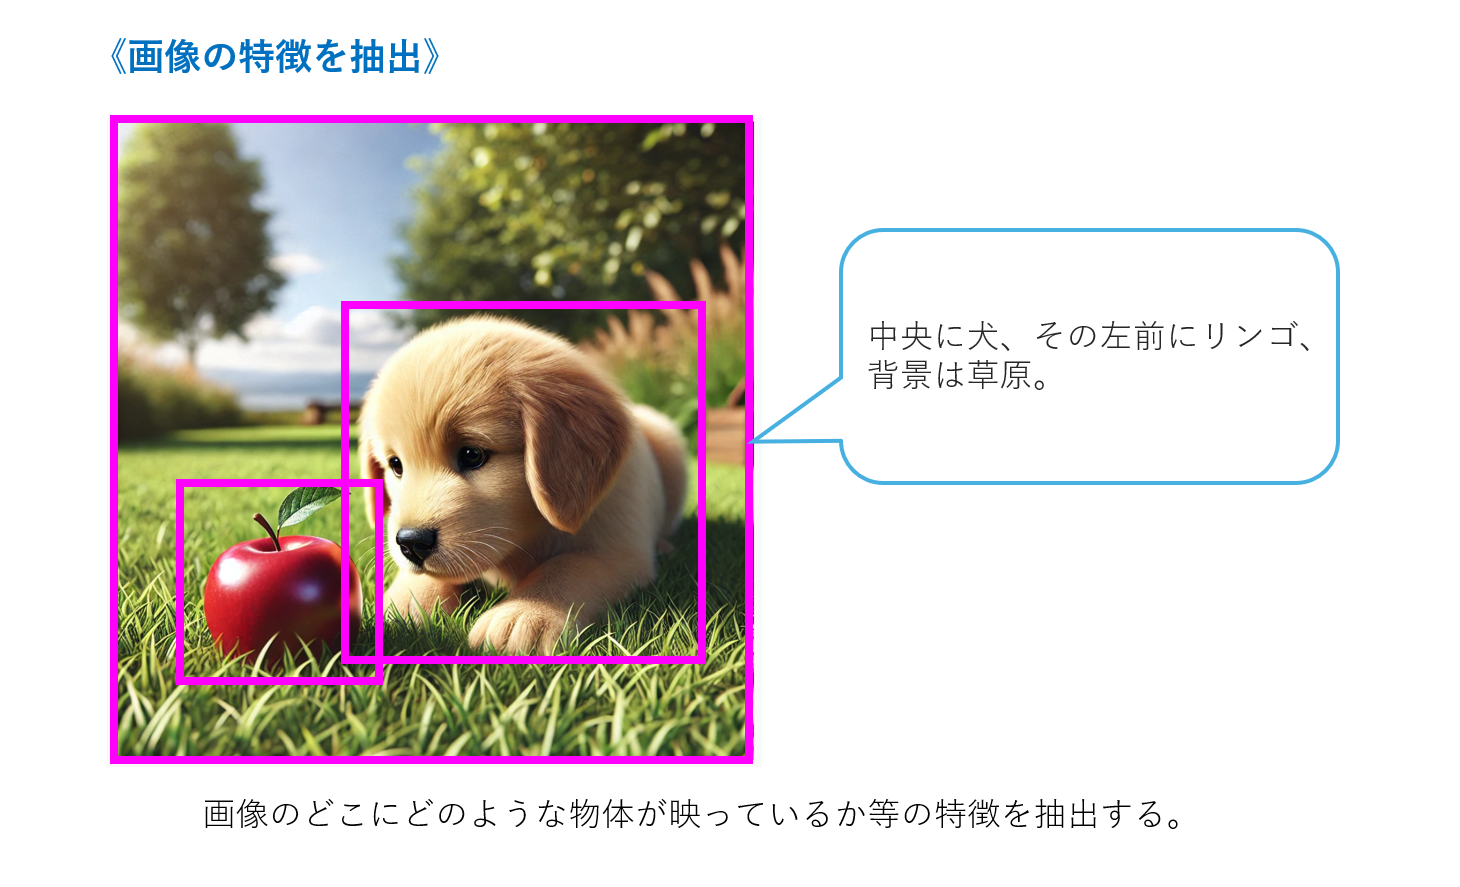
画像に映る物体を 「認識」する過程が「画像の特徴の抽出」なんだね
3.画像の特徴とテキストを関連付け
次に、前の手順で抽出した画像の特徴と、テキストの関連付けを行います。
例えば、画像の犬が映る部分に、「犬」というテキストを関連付けることで、「この物体は犬である」という表現ができるようになります。
人間であれば、画像を見て何が映っているかを言葉にすることは簡単ですが、コンピュータにとっては「画像」と「テキスト」は異なる種類の情報になるため、一度に理解することは困難です。
このような異なる情報の橋渡しを行い、画像の特徴とテキストの関連付けがこの手順で行われます。
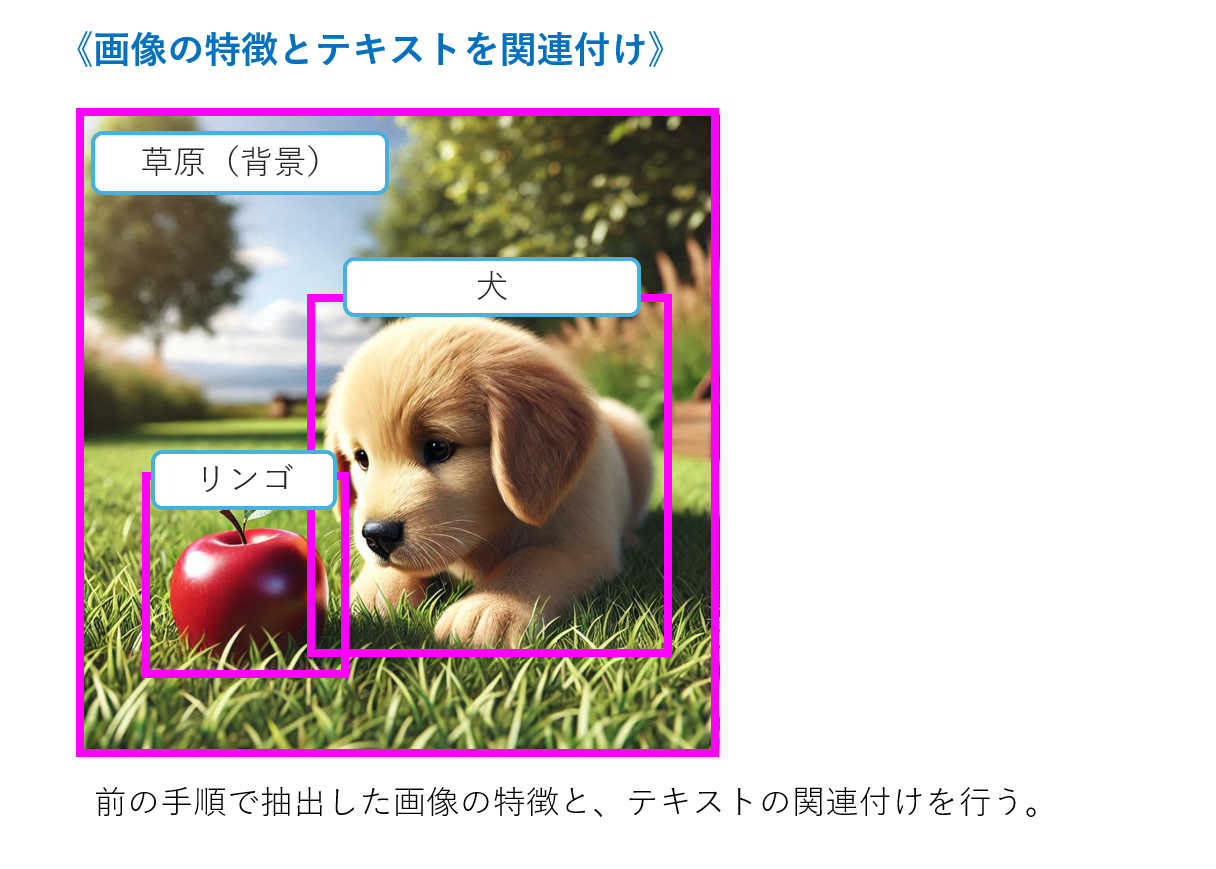
この過程で 「画像に映る物体は犬である」っていう風に 画像とテキストが関連付けられるんだな
4.テキストを生成
最後に、前の手順で得た画像とテキストの関連付けの情報を基に、人間が理解できる自然な文章を生成します。
これにより、「この画像には何が映っていますか?」等の質問に対して、「この画像は、草原を背景に、犬とリンゴが映っています。」という自然な文章を生成することができます。
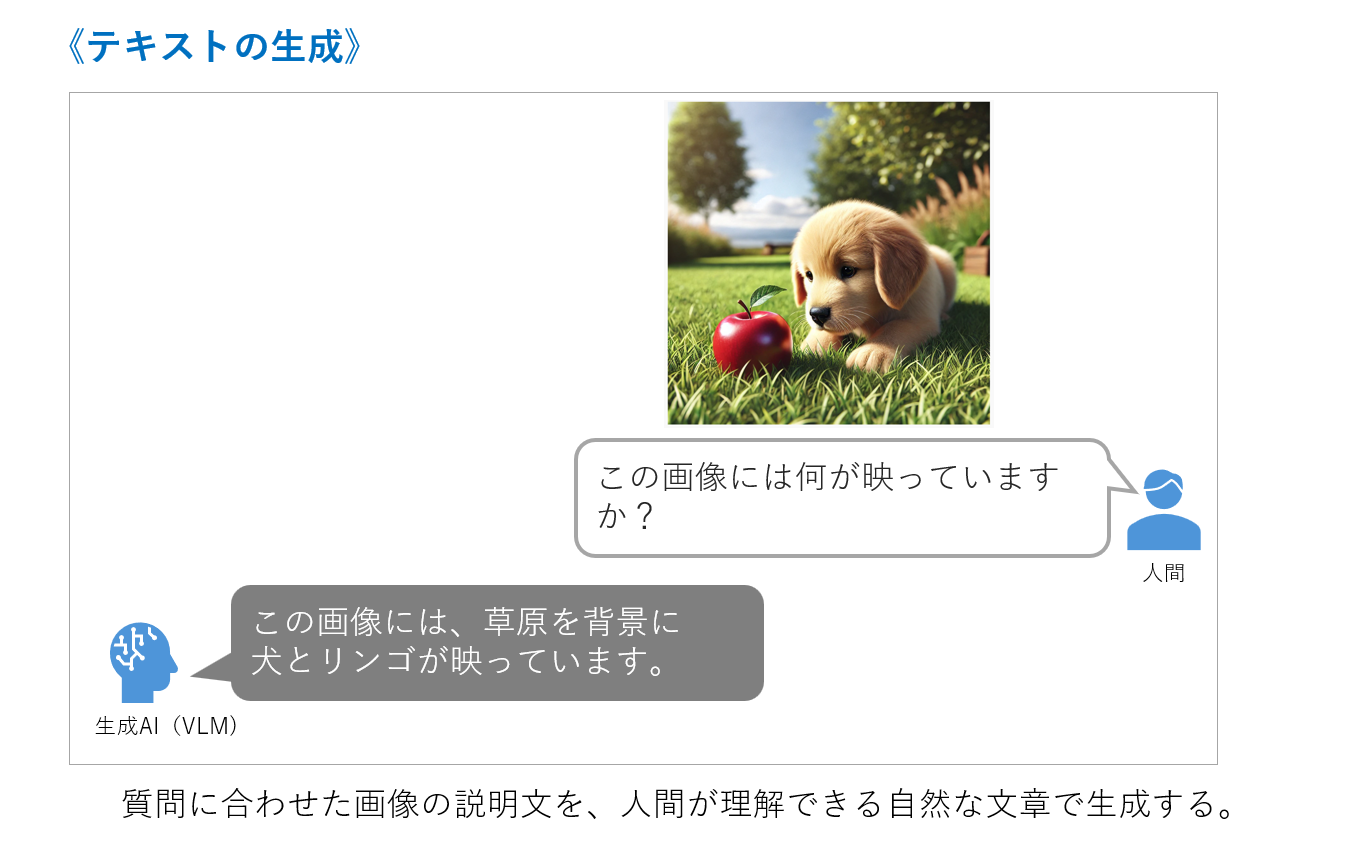
このようにVLMは 画像を認識して その画像に合ったテキストを生成することができます
VLMは「画像を分析する技術」とも言えますよ
VLMの活用事例
画像キャプション機能としての活用
VLMの代表的な機能の一つに、画像を認識して正しい説明のテキストを生成する「画像キャプション」があります。
「Be My AI」は、この画像キャプション機能を使い、視覚に障害がある方のために、カメラで撮影した写真や、Webサイトの画像などを認識して、詳細な説明を音声で読み上げる機能を搭載しています。
これにより、視覚に障害がある方にとって、写真が身近な存在になることが期待されています。
以下の動画では、実際に「Be My AI」を使って、いくつかの写真のキャプションを生成し、音声で読み上げる様子を見ることができます。
画像キャプション機能活用したアプリ「Be My AI」(4:58~7:50)
引用元:ニポラチャンネル「第69回 これは便利!【続編】iPhoneアプリBe My AIで写真を解析」
画像の詳細を 思っていた以上に正確に説明していて驚きました!
目をつぶって音声を聞いてみると 実際にその画像のイメージがわいてきますね
ピッキングロボットでの活用
Google社の「PalM-E」は、VLMの技術を活用したピッキングロボットです。
人間からのテキストによる指示に対して、ロボットに搭載されているカメラで周囲の環境を認識して、正確に指示をこなすことができます。
以下の動画の0:10~0:42では、人間が「緑の星の形をしたものを私に運んで。」と指示を出しており、その指示通りにカメラで物体の認識を行い、人間のもとに運んでいる様子を見ることができます。
次に、0:43~では、人間が「引き出しからお菓子を取り出して私に運んで。」という指示を出しており、少し時間が掛かっていますが、同じく指示通りに引き出しからお菓子を取り出し運ぶ様子が見られます。
VLMを活用したロボット「PalM-E」
引用元:New Scientist「Watch Google’s AI robot autonomously complete an array of physical tasks」
人間が出す指示に従って正しく動くなんてすごいな!
ロボットって決められたことだけを行うイメージがあったけど そのイメージがくつがえりそうだよ
VLMについて 理解は深まりましたか?
VLMは AIに「目」と「口」の役割が備わった技術になります
今後 この技術の発展により 私たちの生活はより便利で素晴らしい未来になることが期待されています

