
須多先生
みなさん こんにちは
本日も一緒に人工知能について学びましょう
2. チャット学習① ( 2 / 11 )

須多先生
みなさん こんにちは
本日も一緒に人工知能について学びましょう
須多先生
前回は 画像生成AIについて学びましたね
いかがでしたか?
徳井 天
テキスト生成AIと同じようにプロンプトを与えるだけで 本格的な画像が簡単に生成できることが興味深かったです!
深田 あい
オリジナルの歌詞に合わせた画像生成の演習を通して 効果的なプロンプトの与え方についても身についたと思います
徳井 天
プロンプトに含める単語一つで 全く別の画像が生成されて驚いたんだよな
須多先生
作りたい画像を生成するためには 具体的で明確な文章をプロンプトとして与えることが大切だと学びましたね
徳井 天
そういえば先生 今回のレッスンでは何を学ぶんですか?
須多先生
今回は 生成AIの一種である「VLM(Vision-Language Model:ビジョンランゲージモデル)」について学びます
徳井 天
ビジョン…ランゲージモデル…で VLMですか…
深田 あい
なんとなく VLMとLLM(大規模言語モデル)は名前が似ていますね
何か関係があるんですか?
須多先生
よく気が付きましたね
実は 「VLM」には LLMの要素が入っているんです
須多先生
「VLM」は簡単に説明すると 画像と文章を組み合わせて理解する生成AIになります
徳井 天
テキスト生成AIと 画像生成AIを合体させたようなイメージですかね…?
須多先生
はい そのイメージで問題ありませんよ
須多先生
例えば テキスト生成AIに「富士山について教えてください」と聞くと 正しく回答してくれることは皆さんも知っていますよね
深田 あい
はい
LLMを使ったテキスト生成AIが 質問に合わせて回答してくれるんですよね
須多先生
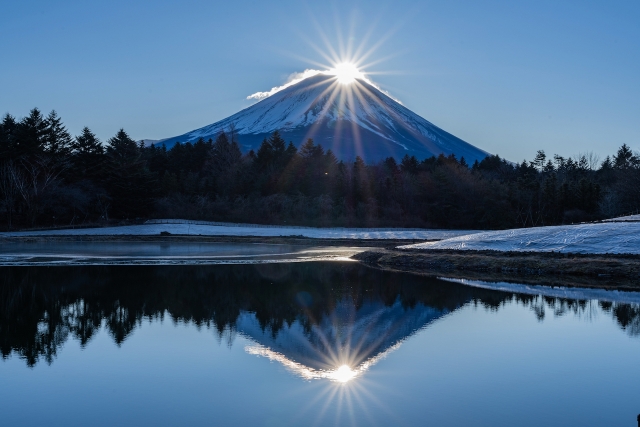
一方「VLM」では 例えばこのような 富士山が映った画像を見せます
須多先生
次に文章で 「この画像に映るものについて教えてください」と質問すると 「この画像はダイヤモンド富士という現象です」と 画像の詳細について 正しく回答をしてくれるんですよ
深田 あい
AIが画像に何が映っているのかを認識しているってことですか?
徳井 天
今までは 文章をプロンプトとして与えてテキストや画像を生成してきたけど 逆に画像を与えることでテキストを生成するってことか!
深田 あい
VLMってすごいですね!もっと詳しく知りたいです!
須多先生
それでは次のスライドで 「VLM(Vision-Language Model:ビジョンランゲージモデル)とは?」について詳しく学びましょう

