
このスライドでは三目並べや五目並べを題材にして「ルールベース」と「強化学習」のPythonプログラムの違いについて学びましょう
10. スライド学習① ( 10 / 14 )

三目並べと五目並べのPythonプログラム
「ルールベース」と「強化学習」の違いについての重要ポイント
以下の図は、従来の「ルールベース」とAIの「強化学習」のプログラミングの違いをまとめたものです。
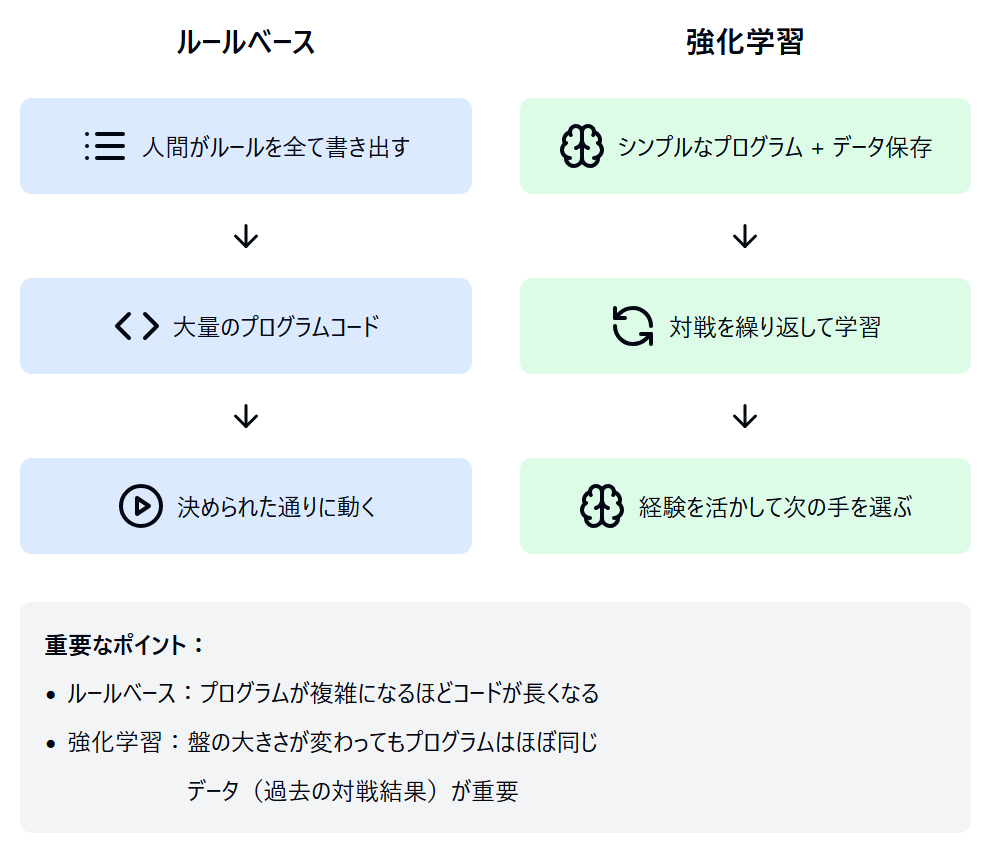
このスライドで理解していただきたいのは それぞれプログラミングの「考え方」が全く異なるという点です
特に強化学習のようなAIは プログラムよりも「データ」が重要である点に注目して 確認していきましょう
Pythonプログラムによる盤面の表現について
三目並べと五目並べの「強化学習」を使ったPythonプログラムはどのように書かれるのか確認しましょう
まずは「変数」と「ルールベース」でのPythonプログラムをおさらいしてから 「強化学習」のPythonプログラムを確認しましょう
盤面とマスごとの変数の確認
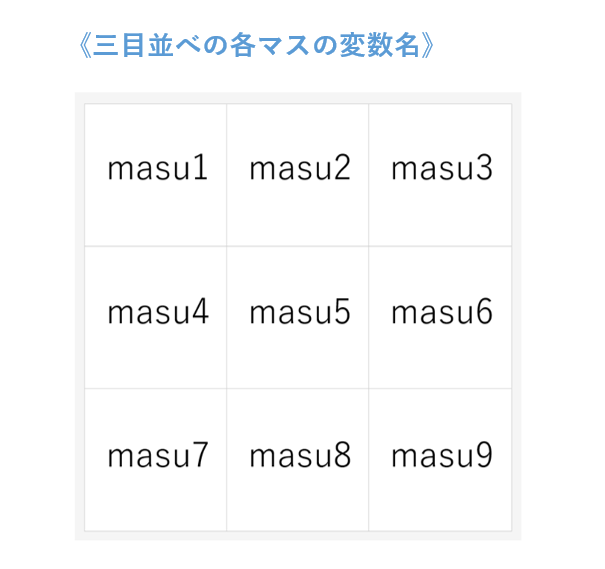
「三目並べ」の盤面は3×3の合計9マスとなり、左上から順番に、盤面のマスを「masu1」~「masu9」という「変数名」で表します。
一方、「五目並べ」の盤面は5×5の合計25マスとなり、左上から順番に、盤面のマスを「masu1」~「masu25」という「変数名」で表します。
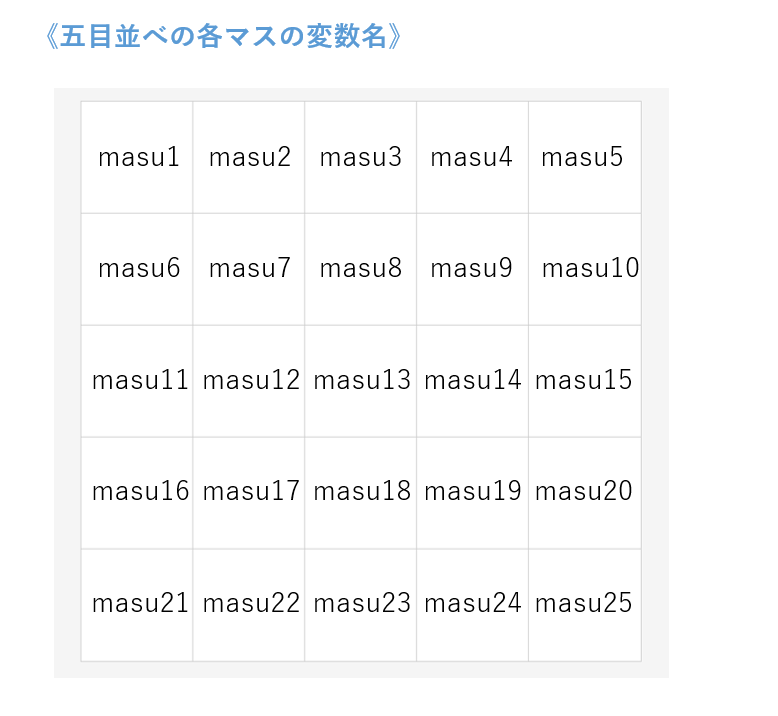
例えば、一番左上に「〇」の石が置かれている場合、「masu1」の中には「〇」が入っている状態になります。
また、何も置かれていないマスには、空いているマスであることが分かるように「―」というデータを入れておくことにします。
本来の「五目並べ」は ゲーム性を高めるために「15×15」や「19×19」の盤面で行われますが このレッスンでは「5×5」の盤面で説明を行います
「ルールベース」のPythonプログラム
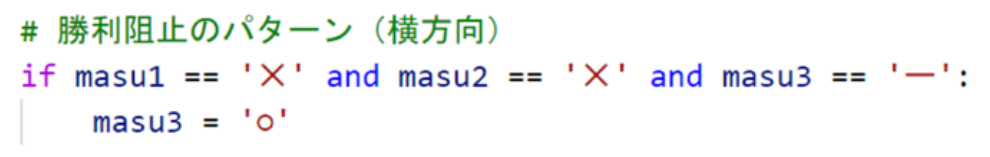
以下のPythonプログラムは、前回のレッスンで行った「ルールベース」での三目並べのPythonプログラムの一部です。
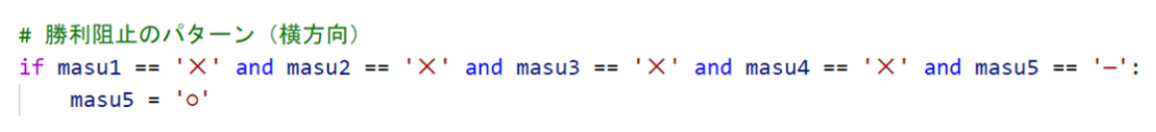
現在、先手(〇)の場合、盤面の左上のマス(masu1)とその横のマス(masu2)に相手の「×」の石が並んでおり、右上のマス(masu3)が空いている状態(空いているマスには'-'のデータが入っている)であることが、一行目の条件に記述されています。
次に、二行目には、一行目の条件が成立するとき、空いている右上のマス(masu3)に'〇'の石を置き、相手の勝利を阻止する「勝利阻止」のルールが記述されています。
そして、これと同じように「勝利阻止」の判定を五目並べで記述すると、以下のようなif文になります。
次に、三目並べと五目並べのルールベースのPythonプログラムの全体像を見てみましょう。
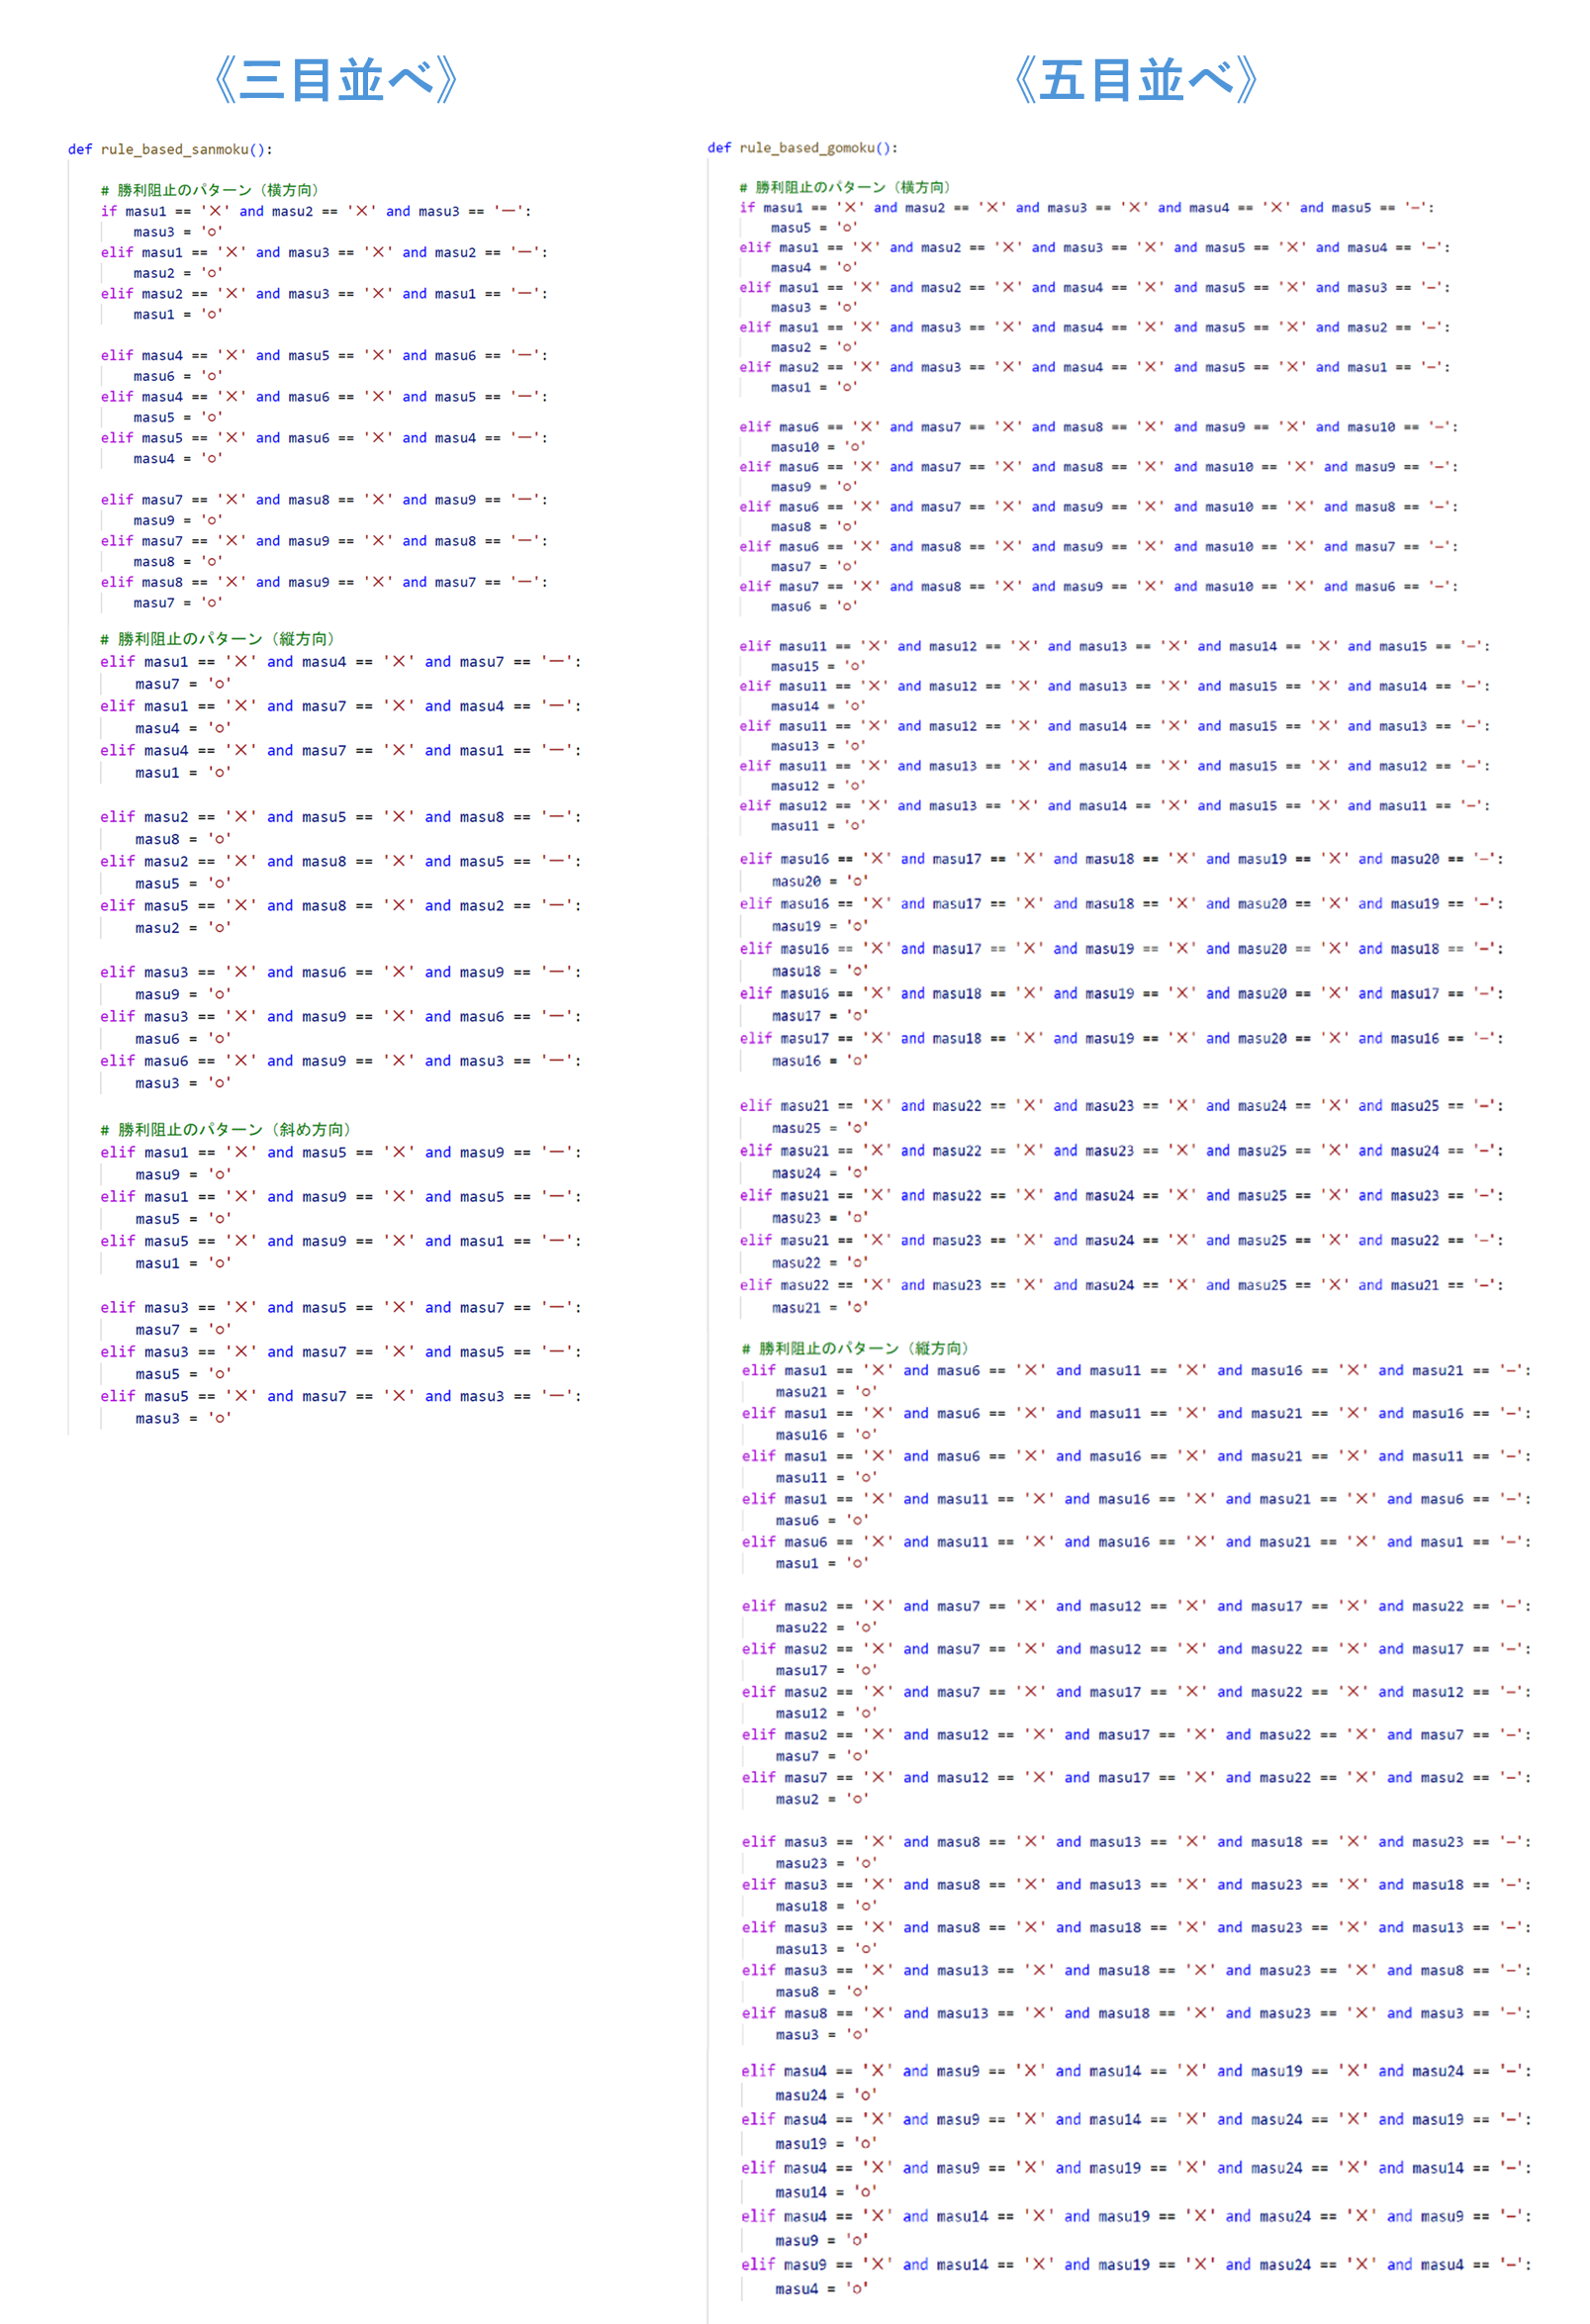
ここではプログラムのボリュームの違いを確認するため、文字はとても小さくしてありますので、内容を確認する必要はありません。
三目並べと五目並べで同じようなことを実現しようとした場合に、ルールベースだとこれだけ記述する量が違うことに注目してください。
三目並べと比べると 五目並べの方は 行数も文字数も すごい量になっているな…
今回見ていただいたPythonプログラムは、「勝利阻止」の戦術だけが書かれています。
三目並べでの「勝利阻止」のPythonプログラムで、「縦・横・斜め」を判定するif文は全部で24パターンとなります。
五目並べの場合の「勝利阻止」のPythonプログラムでは、if文のパターンは大幅に増え、全部で60パターンとなります。
これに加えて、前回のレッスンで学んだ「勝利確定」や「中央優先」などの戦術をPythonプログラムで書く場合、大量のif文が必要になります。
こんなにたくさんの量のプログラムなのに 「勝利阻止」の戦術だけしか書かれてないんですか!?
全部の戦略をPythonプログラムで表すとしたら 何行書かなきゃいけないんだろう…
では次に 強化学習を使ったPythonプログラムを見てみましょう
「強化学習」のPythonプログラム
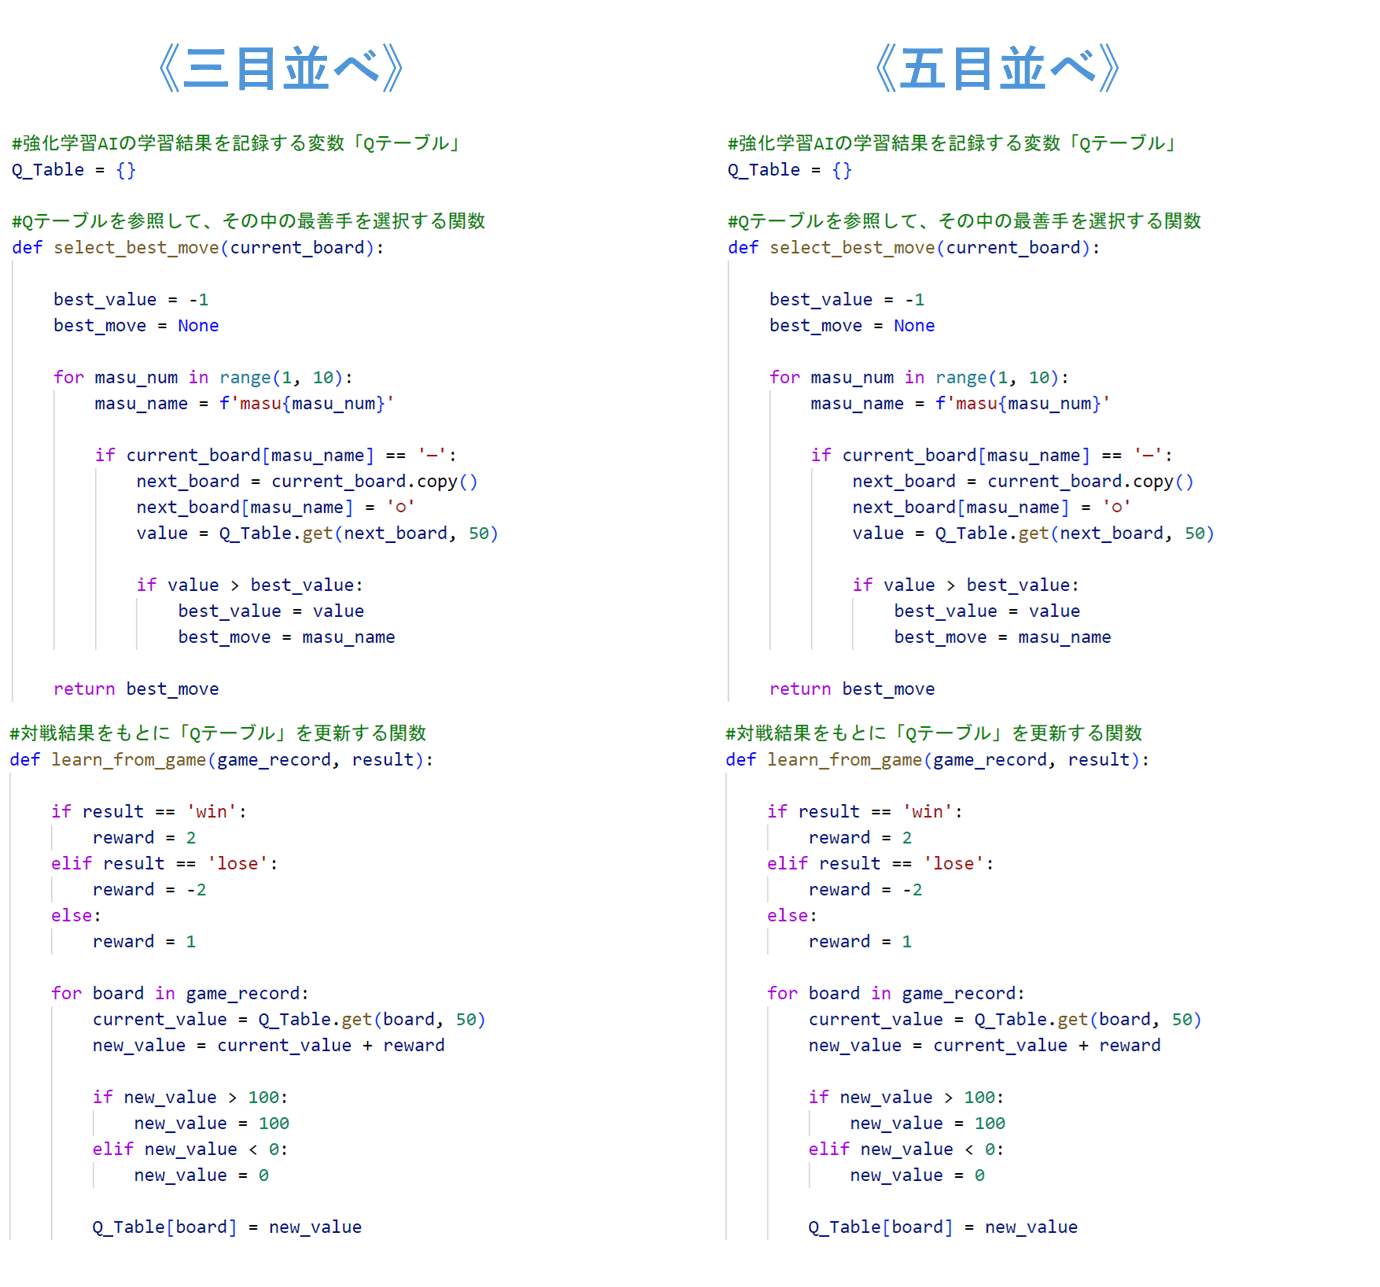
ここでは、三目並べと五目並べの、強化学習のPythonプログラムの全体像を見てみましょう。
あれ?よく読んでみると どっちもほとんど変わらないような気がしますね…
三目並べと五目並べの、強化学習のPythonプログラムは、実は全く同じ書き方になります。
それでは、先ほど確認したPythonプログラムには、どのようなことが書いてあるかを確認してみましょう。
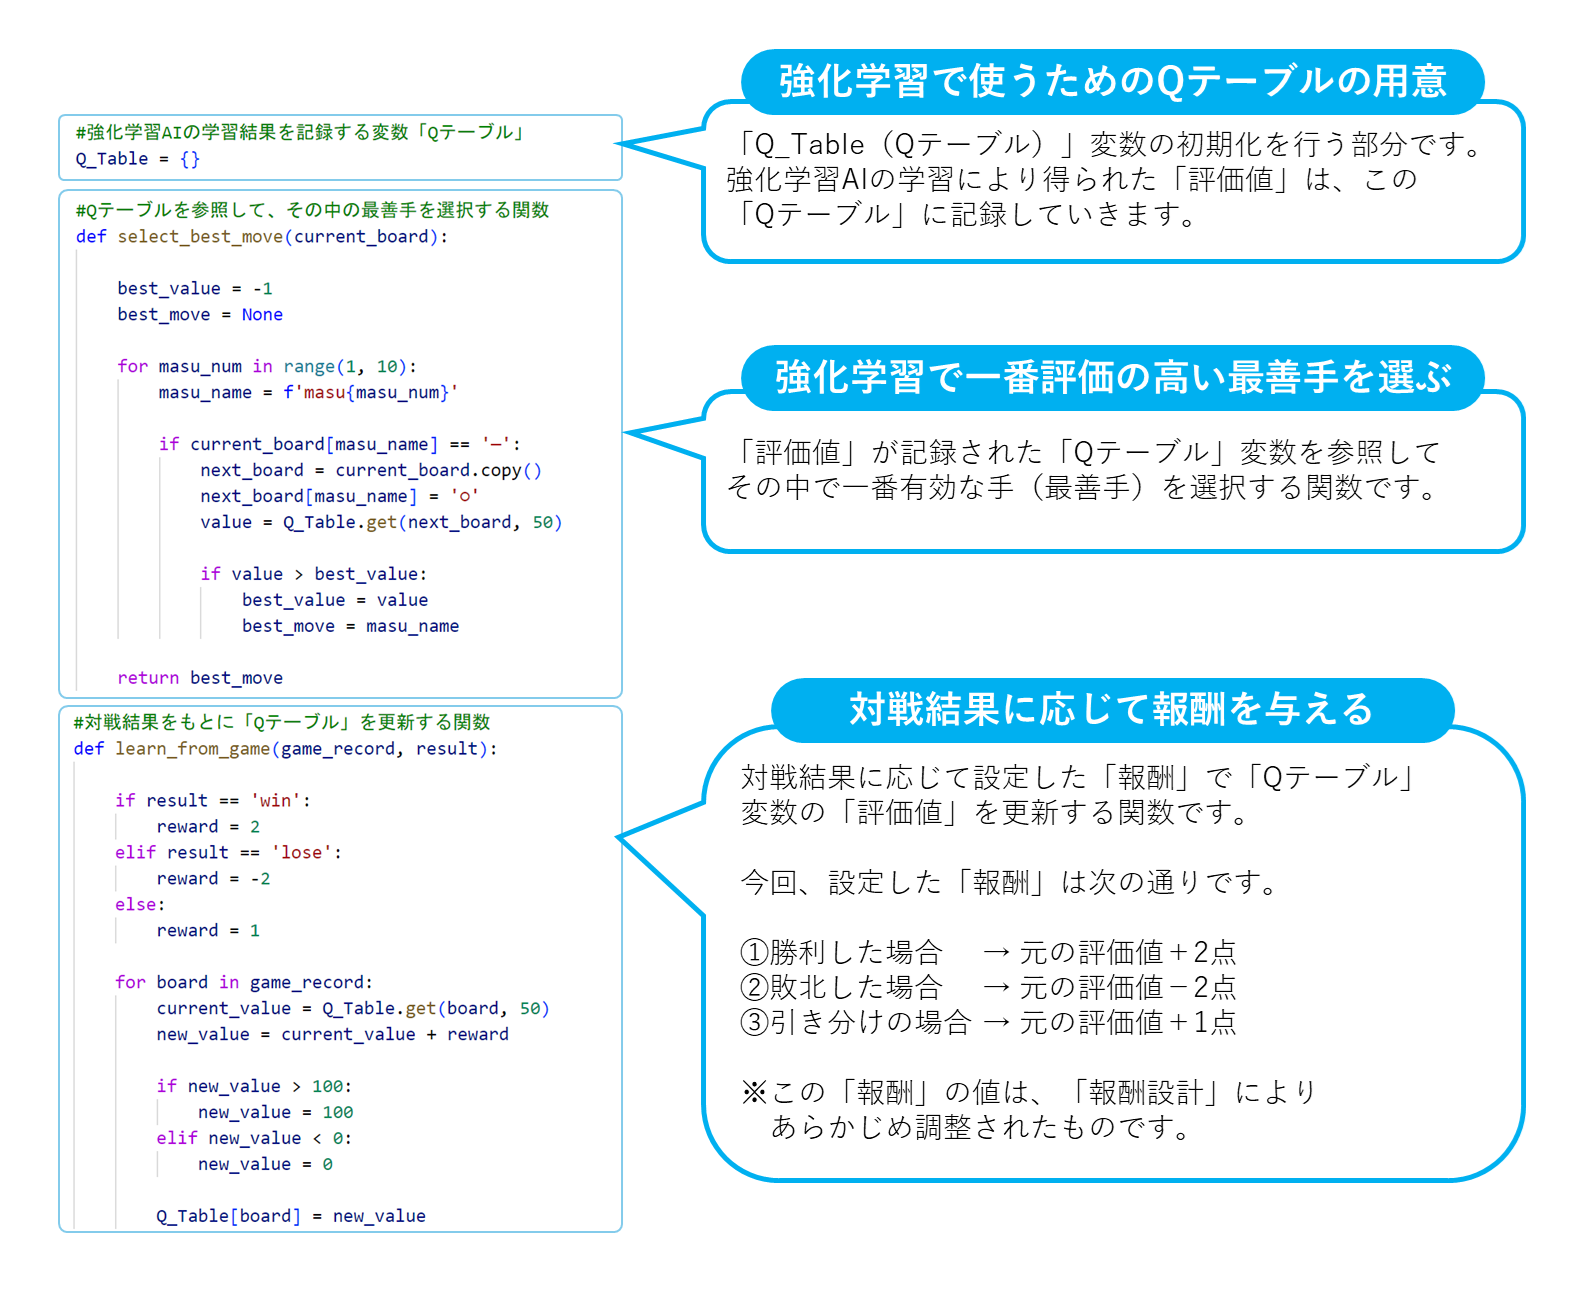
三目並べと五目並べにおけるPythonプログラムの違いは、「Qテーブル」変数に格納されるデータの違いだけです。
このPythonプログラムを実行すると、AIは強化学習を通して対戦を行い、その結果が次々と「Qテーブル」に格納されていきます。
このとき、三目並べと五目並べでは「Qテーブルに格納されるデータ量」にも違いがあります。
「ルールベース」では 特にPythonプログラムの量に違いが出たと思うけど 「強化学習」で大きな違いが無いのは何でだろう?
プログラムの通りに動く「ルールベース」は「プログラムそのもの」が大事になります
ですが「強化学習」では 「プログラムそのもの」よりも AI自身が行う「学習データ」に大きな役割があるため Pythonプログラムに大きな違いは出ないのです
この「学習データ」を格納していく「Qテーブル」について詳しく見ていきましょう
「Qテーブル」とは
強化学習では、対局を繰り返すごとに、盤面ごとの「評価値」を更新し、AIはこれをもとに次に打つ手を考えます。
対戦を繰り返すことで得られたこのデータは、「Qテーブル」変数に格納されます。
例えば、一度も学習をしていない状態の三目並べの「Qテーブル」は、以下のようになります。
「Qテーブル」の中身は{}の中に書かれますが、以下の例では何も書かれておらず「空(何もない状態)」であることが分かります。
次に、学習を行った状態の「Qテーブル」を見てみましょう。
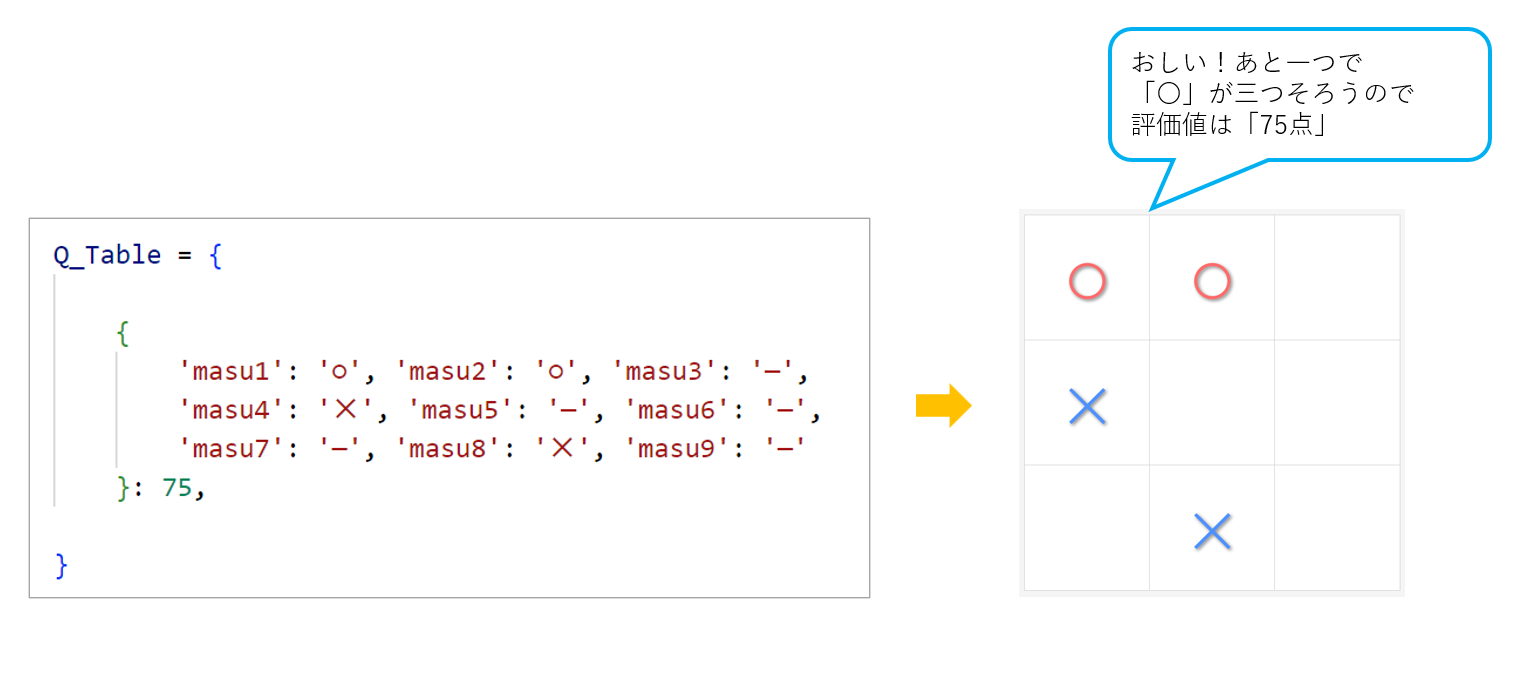
以下の図の左側が「Qテーブル」を表すPythonプログラムです。この「Qテーブル」自体が、三目並べの盤面を示しています。
「Qテーブル」の中に書かれてある「'masu1':'〇'」や「'masu4':'✕'」は、それぞれのマスに置かれた石を表します。また、「―」は石が置かれていない「空白」を表しています。
末尾に書かれてある「:75」という数値は、「〇」を打つ側が強化学習AIのときに、この盤面の評価値は「75点」であることを表しています。
もう一つ、学習を行った状態の「Qテーブル」を見てみましょう。
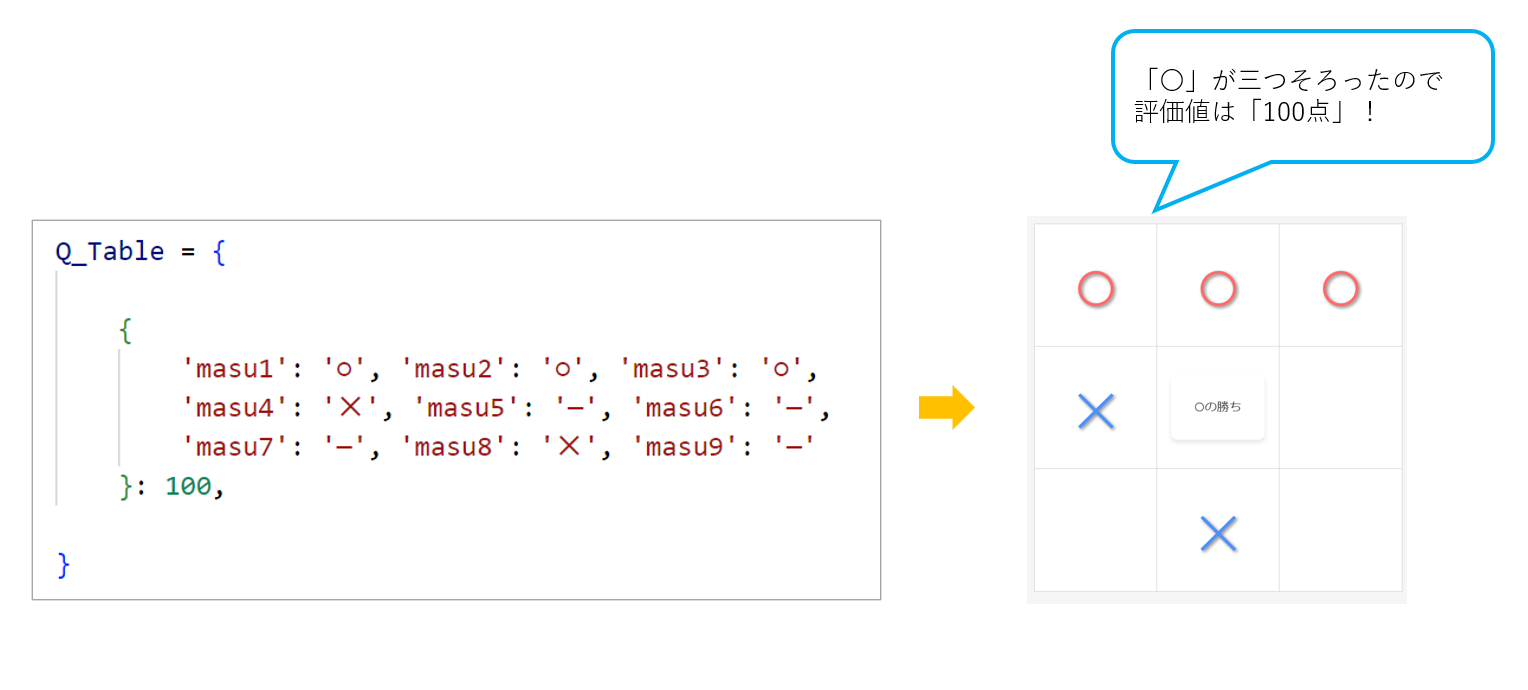
この「Qテーブル」では、盤面の一番上の横のラインに「〇」が三つ揃っている状態を表しています。
末尾の「:100」は、「〇」を打つ側が強化学習AIのときに、この盤面の評価値は「100点」であることを表しています。
最初は難しそうだなと思ったけど 盤面を「〇」「✕」「―(空白)」の記号で表していることに気づければ そこまで難しくはないな
それでは次は 五目並べの「Qテーブル」を見てみましょう
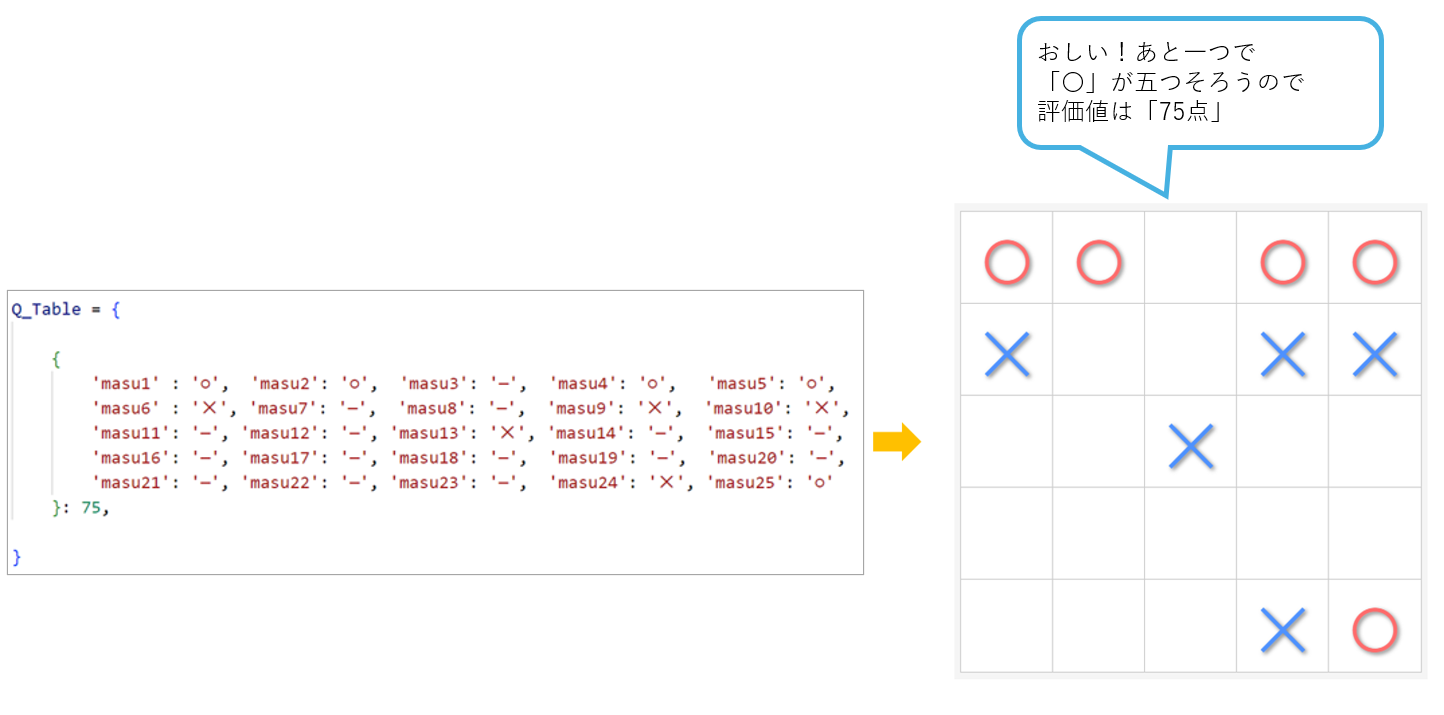
五目並べの「Qテーブル」は、三目並べとほぼ変わりません。
以下の例では、「〇」を打つ側が「強化学習」AIのときに、盤面の評価値は「75点」であることを表しています。
この仕組みでは、AIが対戦を繰返し行うほど、何パターンもの「盤面」と「評価値」の組み合わせが「過去の対戦データ」として保存されていきます。
「強化学習」では、保存された「Qテーブル」のデータをもとに、「評価値が最も高い手」を次の一手として選択することで、強力なAIを育成することができます。
「ルールベース」と「強化学習」の違いについてのまとめ
それでは最後にもう一度、「ルールベース」と「強化学習」の違いについて、以下の図で確認しましょう。
大量のPythonプログラムが必要な「ルールベース」と違って 「強化学習」の方がプログラムの量も少ないし 経験を活かして学んでいくから 効率よく強いAIを作ることができる気がします
AIが自ら学習する「強化学習」を使ったPythonプログラムについて 理解できましたか?

